
अनुमानित डिकोडिंग की व्याख्या से पता चलता है कि कोई भी LLM तीन गुना तेज निष्कर्ष कैसे प्राप्त कर सकता है।
अनुमानित डिकोडिंग गुणवत्ता को संरक्षित करते हुए 2 से 3 गुना तेज आउटपुट के लिए समानांतर में tokens का मसौदा तैयार करने और सत्यापित करके LLM निष्कर्ष की गति बढ़ाता है।
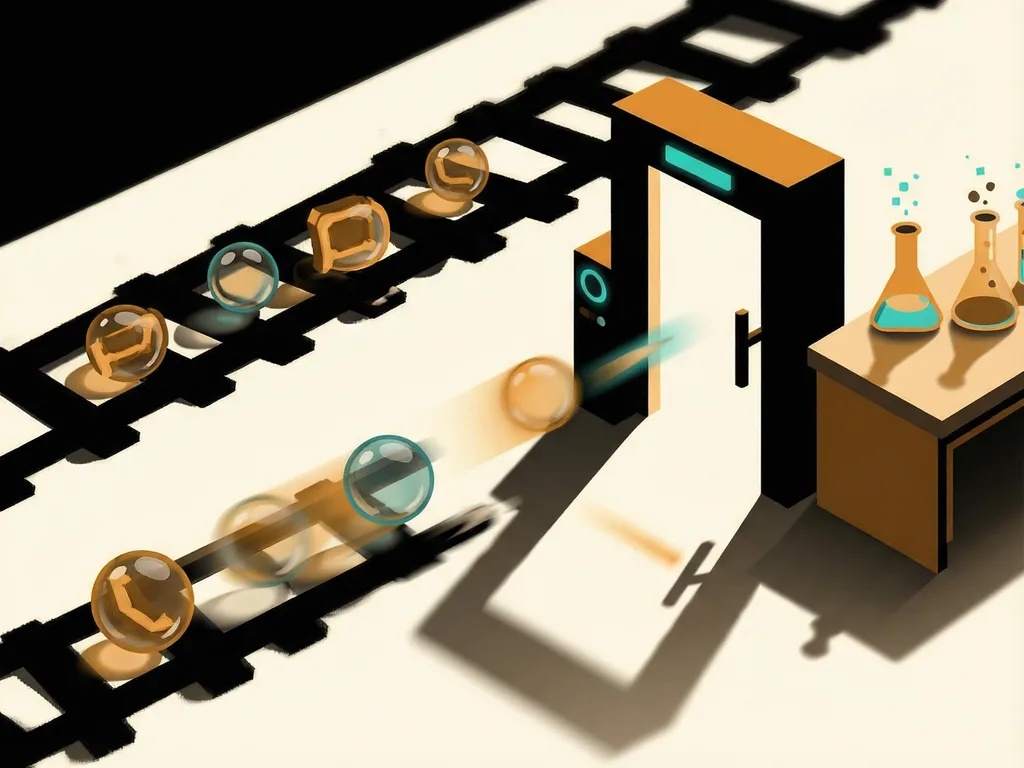
मुख्य जानकारी
- अनुमानित डिकोडिंग एक तेज ड्राफ्ट मॉडल को एक बड़े लक्ष्य मॉडल के साथ जोड़कर, जो समानांतर में कई उम्मीदवार tokens का सत्यापन करता है।
- सामान्य ऑटोरेग्रेसिव LLM पीढ़ी धीमी है क्योंकि प्रत्येक token को मेमोरी से large model भार लोड करने की आवश्यकता होती है, जबकि सट्टा डिकोडिंग एक लक्ष्य-मॉडल पास में कई उम्मीदवारों tokens की जांच करके इस लागत का भुगतान करती है।
- यह विधि संभाव्यता स्वीकृति और सुधार का उपयोग करके लक्ष्य मॉडल के सटीक आउटपुट वितरण को संरक्षित करती है, इसलिए गति वृद्धि कई tokens स्वीकार करने से आती है, न कि मुख्य मॉडल के अनुमान से।
- वास्तविक दुनिया के लाभ ड्राफ्ट-लक्ष्य जोड़ी और स्वीकृति दर पर बहुत अधिक निर्भर करते हैं; अच्छी तरह से मिलान किए गए मॉडल उपयुक्त कार्यों पर 70%80%80% स्वीकृती प्राप्त कर सकते हैं, जबकि खराब रूप से मेल खाने वाले मसौदे ओवरहेड जोड़ सकते हैं और धीमा हो सकते हैं।
- मेडुसा, ईगल और Prompt Lookup Decoding जैसे वेरिएंट एक अलग ड्राफ्ट मॉडल की आवश्यकता को कम या हटा देते हैं, सादगी या थ्रूपुट में सुधार करते हैं लेकिन कभी-कभी मूल सख्त वितरण गारंटी से दूर होते हैं।
मेटा विवरण: अनुमानित डिकोडिंग उम्मीदवार tokens का मसौदा तैयार करके और उन्हें समानांतर में सत्यापित करके LLM निष्कर्ष को तेज करता है, अक्सर 2x से 3x तेजी से आउटपुट प्रदान करता है।
टैगः अनुमानित डिकोडिंग, LLM निष्कर्ष, GPU मेमोरी bandwidth , मॉडल सर्विंग, मेडुसा ईगल
tokens का प्रस्ताव करने वाले एक छोटे ड्राफ्ट मॉडल और समानांतर में उन्हें सत्यापित करने वाला एक बड़ा लक्ष्य मॉडल के साथ, नरम रंगों में, कोई वास्तविक लोग नहीं हैं, कोई लोगो नहीं है।
अनुमानित डिकोडिंग large language models के लिए एक निष्कर्ष तकनीक है जो पाठ पीढ़ी को 2x से 3x तक तेजी से कर सकती है, बिना रीट्रेनिंग, मॉडल वजन बदलने या आउटपुट गुणवत्ता कम किए। यह chatbots की सेवा करने वाली टीमों, कोडिंग सहायकों, customer service बॉट्स या रीयल-टाइम एजेंटों के लिए मायने रखता है, क्योंकि ये एप्लिकेशन प्रत्येक token का उत्पादन करने की लागत से बाधित होते हैं। विधि समानांतर सत्यापन चरण के साथ एक त्वरित मसौदा कदम जोड़कर काम करती है, इसलिए large model अपने स्वयं के आउटपुट वितरण को ठीक से संरक्षित करते हुए कई उम्मीदवार tokens को संसाधित कर सकता है।
सामान्य LLM पीढ़ी धीमी क्यों है
large language models ऑटोरेग्रेसिव रूप से पाठ उत्पन्न करते हैं. इसका मतलब है कि मॉडल अब तक उत्पादित tokens को पढ़ता है, इसके मापदंडों में एक पूर्ण गणना चलाता है , एक नया token उत्सर्जित करता है, फिर अगले token के लिए प्रक्रिया दोहराता है। लंबे उत्तर के लिए, वह सीरियल पैटर्न विलंबता पर हावी हो सकता है।
सीमित कारक अक्सर कच्चे गणित की गति नहीं होती है। Modern AI hardware , जैसे कि NVIDIA H100 GPUs, मॉडल अनुमान के लिए आवश्यक मैट्रिक्स ऑपरेशन बहुत जल्दी कर सकते हैं। समस्या यह है कि मॉडल के अरबों पैरामीटर GPU मेमोरी में रहते हैं, और प्रत्येक token का उत्पादन करने से पहले भार को processor में स्थानांतरित किया जाना चाहिए। इंजीनियर इस स्थिति को मेमरी- bandwidth बाउंड कहते हैं। उस राज्य में, कंप्यूटिंग इकाइयां डेटा की प्रतीक्षा में अपना अधिकांश समय बिताती हैं, इसलिए अधिक processor थ्रूपुट जोड़ने से जरूरी नहीं कि token पीढ़ी तेज हो जाए।
अनुमानित डिकोडिंग कार्य पैटर्न को बदलता है. महंगी मेमोरी-लोड लागत का भुगतान करने के बजाय token प्रति एक बार, यह large model के भारों को लोड करने की कोशिश करता है और उस पास का उपयोग कई उम्मीदवार tokens की जांच करने के लिए करता है।
ड्राफ्ट और सत्यापन लूप
मानक कार्यान्वयन दो मॉडलों का उपयोग करता है। ड्राफ्ट मॉडल छोटा और हल्का होता है, इसलिए यह उम्मीदवार tokens के एक छोटे अनुक्रम को जल्दी से उत्पन्न कर सकता है। विशिष्ट अनुक्रम 4 से 8 उम्मीदवार हैं। प्रारूप मॉडल अभी भी ऑटोरेग्रेसिव रूप से उत्पन्न करता है, लेकिन क्योंकि इसमें बहुत कम पैरामीटर होते हैं, यह मुख्य मॉडल की तुलना में उस चरण के माध्यम से बहुत तेजी से आगे बढ़ सकता है.
लक्ष्य मॉडल बड़ा, उच्च-गुणवत्ता वाला मॉडल है जिसका आउटपुट उपयोगकर्ता अपेक्षा करते हैं। यह उम्मीदवार अनुक्रम प्राप्त करता है और इसे एक बैच ऑपरेशन में स्कोर करता है। एक समय में एक token का मूल्यांकन करने के बजाय, यह पूरे ड्राफ्ट को समानांतर में जांचता है। ऐसा इसलिए होता है क्योंकि GPU कंप्यूटिंग समान कार्य के लिए अच्छी तरह से अनुकूल है, इसलिए एक छोटे बैच को स्कोरिंग करना केवल एक एकल 8800010 की तुलना में थोड़ा अधिक समय ले सकता है।
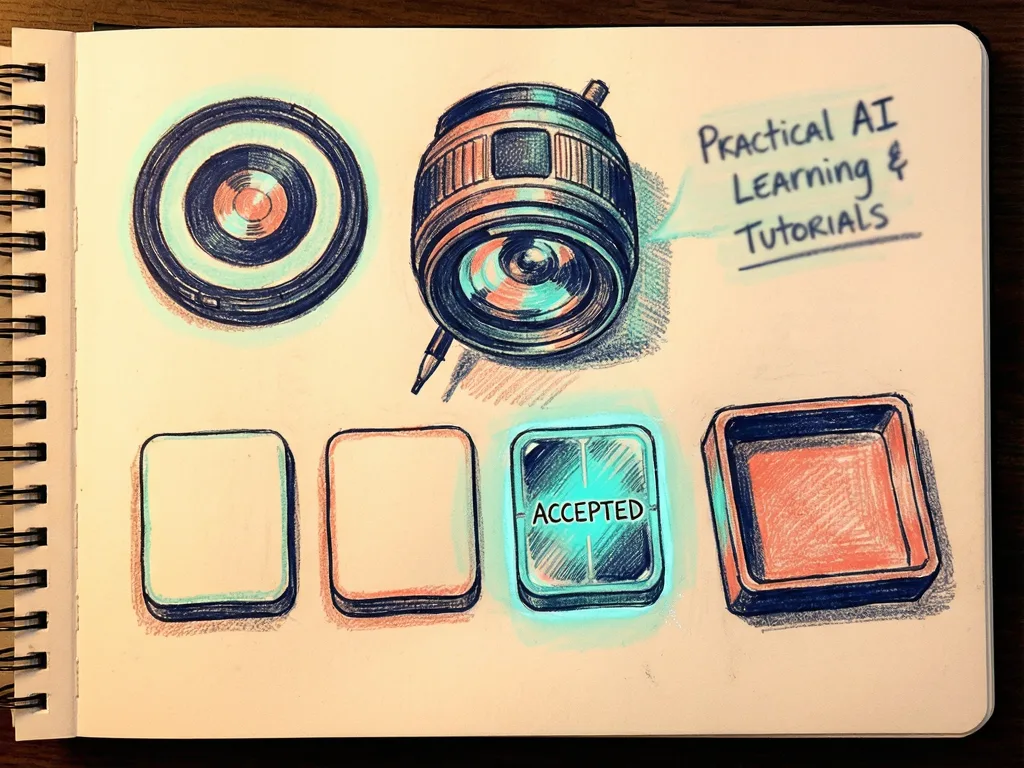
स्वीकृति नियम संभावनावादी है। प्रत्येक उम्मीदवार के लिए, लक्ष्य मॉडल मसौदा मॉडल के विश्वास के साथ अपने स्वयं के आत्मविश्वास की तुलना करता है। यदि लक्षित मॉडल कम से कम ड्राफ्ट मॉडल के रूप में आश्वस्त है, तो उम्मीदवार को स्वीकार किया जाता है। अगर प्रारूप मॉडल अधिक आश्वस्त था, तो अंतर बढ़ने पर कमी होने वाली संभाव्यता के साथ उम्मीदवार को मंजूरी दी जाती है। एक token अस्वीकार कर दिया गया है, सिस्टम दो मॉडलों के बीच अंतराल के लिए जिम्मेदार एक समायोजित वितरण से एक सुधारित 8800010 का नमूना लेता है।
यह सुधार कुंजी गारंटी है. अंतिम आउटपुट में समान संभावना वितरण होता है जैसे कि लक्ष्य मॉडल ने प्रत्येक token को स्वयं उत्पन्न किया हो। गति एक सत्यापन पास में कई tokens स्वीकार करने से आती है, न कि लक्षित मॉडल के अनुमान से।
सबसे अच्छा और सबसे खराब मामला कैसा दिखता है
सर्वोत्तम स्थिति में, ड्राफ्ट के प्रत्येक उम्मीदवार को स्वीकार किया जाता है और लक्ष्य मॉडल अंत में एक अतिरिक्त token का उत्पादन भी कर सकता है। यह लगभग एक लक्ष्य मॉडल पास की लागत के लिए 5 से 9 tokens तक उत्पन्न हो सकता है.
सबसे खराब स्थिति में, पहला मसौदा token को खारिज कर दिया जाता है और प्रतिस्थापित किया जाता है। यह अभी भी ड्राफ्ट मॉडल के पीढ़ी का समय खर्च करता है, इसलिए यह मानक डिकोडिंग की तुलना में मामूली ओवरहेड जोड़ सकता है। उत्पादन टीमों के लिए यह महत्वपूर्ण हैः एक बुरी तरह से मेल खाने वाला ड्राफ्ट और लक्ष्य जोड़ी केवल तटस्थ नहीं हो सकती है।
वास्तविक दुनिया की गति स्वीकृति दर पर बहुत अधिक निर्भर करती है। जब अच्छी तरह से मिलान किए गए मॉडल जोड़े सामान्य कार्यों में 70 से 80 प्रतिशत के आसपास स्वीकृती दर तक पहुंचते हैं, तो व्यावहारिक लाभ अक्सर 2x से 3x होता है। अनुमानित या दोहराए जाने वाले पाठ वाले कार्य उच्च स्वीकृत दर और बड़े लाभ का उत्पादन करते हैं।
वेरिएंट जो अलग ड्राफ्ट मॉडल को हटाते हैं
मूल दो-मॉडल सेटअप प्रभावी है, लेकिन यह मेमोरी और इंजीनियरिंग ओवरहेड जोड़ता है क्योंकि एक अलग ड्राफ्ट मॉडल को बनाए रखा जाना चाहिए। कई आधुनिक वेरिएंट उम्मीदवारों के उत्पादन का तरीका बदलते हुए मसौदा और सत्यापन विचार रखते हैं।
मेदुसा अपने अंतिम परत में कई पूर्वानुमान सिर संलग्न करके लक्ष्य मॉडल को संशोधित करता है। प्रत्येक सिर एक अलग भविष्य की token स्थिति का अनुमान लगाता है, जिससे लक्ष्य मॉडल बाहरी ड्राफ्ट मॉडल के बिना अपने स्वयं के उम्मीदवार अनुक्रम उत्पन्न कर सकता है।
ईगल, या Extrapolation Algorithm Greater Language-मॉडल दक्षता के लिए, भविष्य tokens की भविष्यवाणी करने के लिए लक्षित मॉडल के आंतरिक छिपे हुए राज्यों का उपयोग करता है। छुपा हुआ राज्य अकेले अंतिम आउटपुट tokens , जो जटिल या डोमेन विशिष्ट पाठ पर स्वीकृति दरों में मदद कर सकते हैं से अधिक समृद्ध प्रासंगिक जानकारी ले जाते हैं।
Prompt Lookup Decoding कोई माध्यमिक मॉडल की आवश्यकता नहीं है। यह प्रतिक्रिया में फिर से प्रकट होने वाले वाक्यांशों के लिए संकेत और वार्तालाप इतिहास को स्कैन करता है और उन वाक्यांकियों का मसौदा उम्मीदवारों के रूप में उपयोग करता है. यह विशेष रूप से कोड संपादन और दस्तावेज़ सारांश के लिए उपयोगी है, जहां आउटपुट अक्सर इनपुट से शब्दावली और संरचना को प्रतिध्वनित करता है।
इनमें से कुछ वेरिएंट सरल कार्यान्वयन या उच्च थ्रूपुट के लिए मूल विधि की सख्त वितरण गारंटी का व्यापार करते हैं। व्यवहार में, आउटपुट गुणवत्ता पर प्रभाव आम तौर पर नगण्य होता है, लेकिन टीमों को अभी भी अपनी सटीकता और विलंबता आवश्यकताओं के आधार पर जानबूझकर चुनना चाहिए।
कब इसे सक्षम करना है, और कब सावधान रहना है
अनुमानित डिकोडिंग एक अंतर्निहित विकल्प के रूप में उपलब्ध है जैसे कि Hugging Face टेक्स्ट-जनरेशन-इंफेरेंस, vLLM , और llama.cpp। कई टीमों के लिए, इसे सक्षम करना अनुसंधान परियोजना की तुलना में विन्यास परिवर्तन के करीब है।
यह तब सबसे उपयोगी होता है जब आउटपुट लंबे होते हैं, जब सिस्टम एक समय में बड़े बैचों के बजाय एक अनुरोध पर काम करता है और जब प्रॉम्प्ट और प्रतिक्रिया शब्दावली या संरचना साझा करते हैं। प्रश्न का उत्तर देना, दस्तावेज़ सारांशण और कोड पूरा करना ऐसे उदाहरण हैं जहां तकनीक मजबूत लाभ पैदा कर सकती है।
उच्च-थ्रूपुट बैच सेवा अलग है। भारी बैचेड सेटिंग्स में, ड्राफ्ट tokens मेमोरी और कंप्यूटिंग का उपभोग करता है जो अन्यथा अतिरिक्त अनुरोधों की सेवा के लिए इस्तेमाल किया जा सकता था। इसलिए सट्टा डिकोडिंग थ्रूपूट को नुकसान पहुंचा सकती है भले ही यह प्रति-अनुरोध विलंबता में मदद करे। उत्पादन में इसे चालू करने से पहले समझना मुख्य व्यापार-बंद है।
आम गलतियाँ
पहली गलती यह मान रही है कि अनुमानित डिकोडिंग हमेशा थ्रूपुट में सुधार करती है. यह अक्सर एकल-अनुरोध विलंबता में सुधार करता है, लेकिन बड़े बैचों को कम लाभ या यहां तक कि एक throughput हानि भी हो सकती है।
यदि प्रारूप मॉडल शायद ही कभी लक्ष्य मॉडल से मेल खाता है, तो स्वीकृति दरें गिरती हैं, ओवरहेड बढ़ता है और गति गायब हो जाती है।
तीसरा कार्यभार को नजरअंदाज कर रहा है। दोहराव, संरचित या शीघ्र-प्रतिध्वनित कार्य अच्छे फिट हैं। अत्यधिक परिवर्तनशील कार्यों से स्वीकृति दर कम हो सकती है, जिससे लाभ छोटा होता है।
व्यावहारिक टेकअवे सरल हैः सट्टा डिकोडिंग एक hardware -जागरूक पीढ़ी की रणनीति है। यह मॉडल को अधिक सक्षम नहीं बनाता है. यह एकल- token पीढ़ी को बैच सत्यापन और स्वीकृति लूप में बदलकर मेमोरी के लिए प्रतीक्षा करने का समय कम करता है। जब ड्राफ्ट और टारगेट मॉडल कार्य को फिट करते हैं, तो यह लक्ष्य मॉडल के आउटपुट वितरण को बिल्कुल बरकरार रखते हुए 2x से 3x तेज अनुमान प्रदान कर सकता है।
Comments (0)