
डेटाब्रिक्स लेकबेस के साथ एजेंटिक मेमोरी बनाना
Databricks Lakebase बीटा प्रबंधित एजेंट मेमोरी, स्वचालित स्कीमा, अनुक्रमण, खोज और सत्रों, थ्रेड्स और उपयोगकर्ताओं द्वारा अलगाव प्रदान करता है।
मुख्य जानकारी
- डेटाब्रिक्स को सितंबर के अंत में Fully Managed Lakebase (बीटा) 2026 एजेंटिक मेमोरी के लिए एक प्रबंधित स्टोर के रूप में पेश किया गया था, जो विरासत Unity Catalog पथ से दूर जा रहा है।
- यह सेवा मेमोरी स्टोरेज, इंडेक्सिंग और रिकवरी को अमूर्त करती है, इसलिए डेवलपर्स को अब पोस्टग्रेज़ योजनाओं को मैन्युअल रूप से परिभाषित करने की आवश्यकता नहीं है जैसा कि Self Managed Lakebase में है।
- स्मृति अलगाव और पुनर्प्राप्ति ऐसे सत्र आईडी, थ्रेड आईडी के रूप में पहचानकर्ताओं पर निर्भर करते हैं; अल्पकालिक मेमोरी वार्तालापों को स्कोप किया जाता है, जबकि दीर्घकालिक मेमरी उपयोगकर्ताओं को स्कॉप की जाती है।
- एजेंटिक मेमोरी को तीन परतों में व्यवस्थित किया जाता है: प्रक्रिया के दौरान चेकपॉइंट स्टेट, टिकाऊ अल्पकालिक स्मृति और उपयोगकर्ता-कुंजीकृत दीर्घकालिक स्मृति।
- डेटाब्रिक्स प्रबंधित मेमोरी वर्तमान में अंतर्निहित निष्कर्षण रणनीतियों को शामिल नहीं करती है, AWS Agentcore Memory के विपरीत, इसलिए टीमों को यह डिजाइन करना होगा कि कैसे एजेंट प्रासंगिक जानकारी का चयन और संग्रहीत करते हैं।
मेटा विवरण: डेटाब्रिक्स ने सितंबर के अंत में एजेंटिक मेमोरी 2026 के लिए पूरी तरह से प्रबंधित लेकबेस बीटा की घोषणा की, Unity Catalog से अपने प्रबंधित स्टोर पथ के रूप में लेकबेस पर जा रहा है।
टैगः #AgenticMemory #DatabricksLakebase #AIInfrastructure #ProductionAgents
विशेष रुप से प्रदर्शित छवि: स्तरित मेमोरी स्टोर, सत्र थ्रेड, उपयोगकर्ता पहचान और खोज पुनर्प्राप्ति का अमूर्त मैत्रीपूर्ण चित्रण, बिना किसी वास्तविक व्यक्ति, लोगो या पाठ के।
एजेंट डेवलपर्स और प्लेटफ़ॉर्म टीमों के लिए सहायक बनाने की आवश्यकता है जो उपयोगकर्ताओं को याद करते हैं, Databricks Lakebase प्रबंधित एजेंट मेमोरी समाचार हैः डेटाब्रिक्स ने घोषणा की Fully Managed Lakebase (बीटा) सितंबर के अंत में 2026, लेगसी Unity Catalog पथ से अपनी प्रबंधित स्मृति पेशकश को एक लेकबेस सेवा पर स्थानांतरित करना। LLMs स्टेटलेस हैं, इसलिए एजेंटों को पूर्व वार्तालापों से तथ्यों और संदर्भ को पुनः प्राप्त करने के लिए बाहरी स्मृति की आवश्यकता होती है। डाटाब्रिक्स का कहना है कि नई सेवा भंडारण, अनुक्रमण और खोज को संभालती है; Self Managed Lakebase और Fully Managed Unity Catalog विरासत बनी रहती है।
पोस्टग्रेज़ योजनाओं से प्रबंधित स्टोर तक
अधिकांश एजेंटिक प्लेटफ़ॉर्म मेमोरी सेवाएं प्रदान करते हैं, जिनमें AWS Agentcore Memory और GCP Vertex AI Memory बैंक शामिल हैं। डेटाब्रिक्स का सूट सितंबर के रूप में काफी बदल गया है Fully Managed Lakebase 2026 (विरासत) एक पोस्टग्रेज़ डेटाबेस को स्व-प्रबंधित स्मृति भंडार के रूप से उपयोग करता हैः बिल्डरों ने स्कीमा को परिभाषित किया और इसका स्वामित्व लिया, बारीक अनाज की अनुमति दी गई, और पारंपरिक SQL डेटा प्रकारों के अनुसार स्मृति फ़ील्ड संग्रहीत किए गए थे । Fully Managed Unity Catalog
Fully Managed Lakebase (बीटा), सितंबर के अंत में घोषित किया गया, नवीनतम डेटाब्रिक्स प्रबंधित मेमोरी स्टोर है। इससे पहले टीमों को लेकबेस पोस्टग्रेस में स्मृति संग्रहीत करने के लिए एक पारंपरिक Postgres स्कीमा को मैन्युअल रूप से परिभाषित करना पड़ता था। अब वे कुछ इनपुट सेट करते हैं और Databricks AWS और Google मैनेज्ड सर्विसेज की तरह स्मृति भंडार कंटेनर को परिभाषित करता है।
पहचानकर्ता अलगाव तय करते हैं
मेमोरी संगठन अलगाव और पुनर्प्राप्ति दक्षता को निर्धारित करता है। प्रमुख पहचानकर्ता सत्र आईडी, थ्रेड आइडी, उपयोगकर्ता आईडी और अभिनेता आईडी हैं। परिभाषाएं ढांचे के आधार पर भिन्न होती हैं, लेकिन अल्पकालिक स्मृति व्यक्तिगत सत्रों के लिए स्कोप की जाती है जबकि दीर्घकालिक स्मृति अलग-अलग उपयोगकर्ताओं के लिए स्कॉप की गई है।
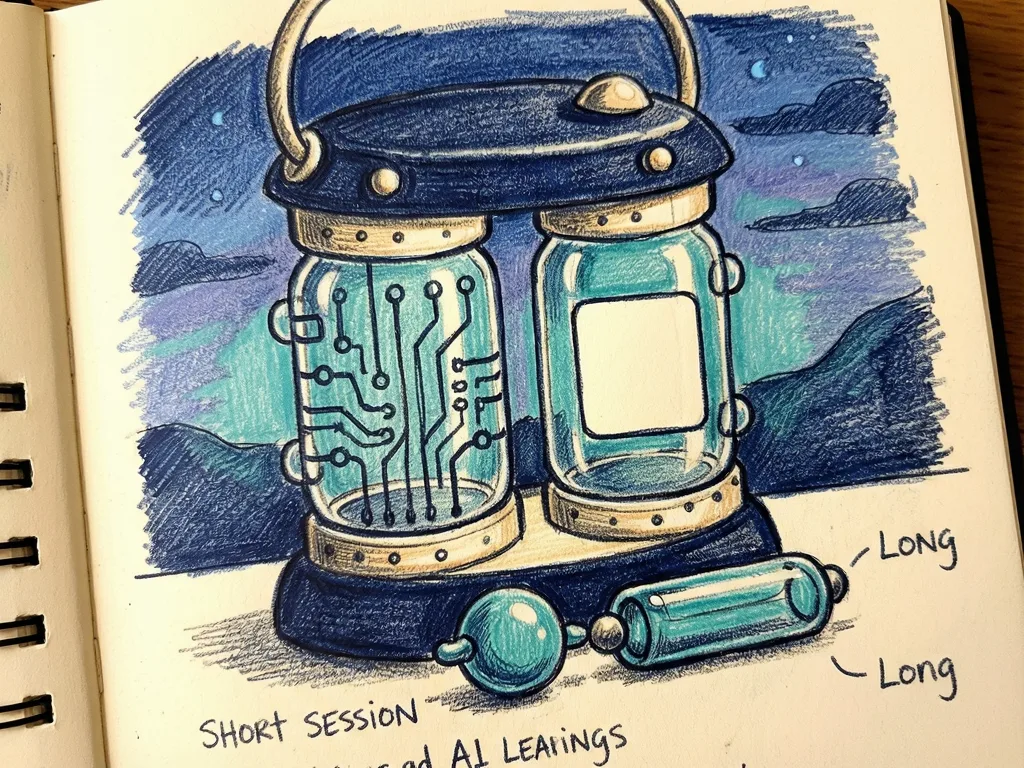
सत्र आईडी एक एकल उपयोगकर्ता इंटरैक्शन का प्रतिनिधित्व करता है, जो APP के सामने बैठने वाले व्यक्ति के बराबर होता है; APP को खोलने से एक नया सत्र ID मिलता है, और कल लौटते हुए दूसरा देता है।सत्र आमतौर पर थ्रेड में मैप होते हैं, अक्सर thread_id = session_id Thread ID लैंगग्राफ में उपयोग किया जाता है, जिसका चेकपोइंटर बातचीत की स्थिति को सहेजने और पुनः लोड करने के लिए इसका उपयोग करता है।एक ही धागा आईडी का उपयोग करके एजेंट संदेशों और टूल कॉल के चल रहे इतिहास को फिर से चला सकता है; एक नई धागा ID खाली शुरू होती है।
User ID एक पहचान अवधारणा है जिसके लिए Identity Provider की आवश्यकता होती है; यह किसी व्यक्ति को पहचानता है और प्रत्येक थ्रेड और सत्र में जानकारी बनी रहती है। थ्रेड्स/सत्र आईडी वार्तालाप द्वारा क्षैतिज रूप से मेमोरी विभाजित करते हैं, जबकि उपयोगकर्ता आईडी इसे मालिक द्वारा लंबवत रूप से विभाजित करता है।
डेटाब्रिक्स प्रबंधित मेमोरी स्टोर के अंदर, प्रत्येक प्रविष्टि में फ्री-फॉर्म टेक्स्ट, एक पुनर्प्राप्ति-सहायता विवरण और तीन स्थान निर्धारण फ़ील्ड होते हैंः actor_id + session_id+ पथ. actor_ID उपयोगकर्ता है, सत्र_आईडी स्रोत सत्र है, और पथ कंटेनर की पहचान करने वाला कस्टम फ़ाइल जैसा नाम है।
तीन स्मृति परतें
एजेंटिक मेमोरी में तीन परतें होती हैं। सबसे क्षणभंगुर इन-मेमोरी चेकपॉइंटर या प्रक्रिया सत्र दृढ़ता है। कई फ्रेमवर्क इसे उजागर करते हैं। लैंगग्राफ का चेकप्वाइंट हर चरण के बाद ग्राफ की स्थिति को स्नैपशॉट करता है, जिसका अर्थ है प्रत्येक नोड निष्पादन। AWS Strands उपयोग करता है Sessions Management और Claude Agents SDK सत्र प्रतिलेखन का उपयोग करती है। ये स्नॅपशॉट्स संदेश और टूल-कॉल इतिहास को संरक्षित करते हैं ताकि एक एजेंट रोक सकता है, फिर से शुरू कर सके, असफल कदम को पुनः प्रयास कर सकता है या उसी पहचानकर्ता का पुनः उपयोग कर सकता हैः थ्रेड_आईडी लांगग्राफ़ में, session_id स्ट्रैंड्स में और Claude Agent SDK डेटा रहता है RAM, स्थानीय विकास के लिए ठीक लेकिन उत्पादन के लिए अस्थिर; एक स्थायी बैकएंड पुनर्प्रारंभ जीवित रहता है।
शॉर्ट-टर्म मेमोरी, Databricks Managed Sessions में एक वार्तालाप के भीतर एजेंट की इन-प्रोसेस स्थिति है जो केवल RAM में आयोजित होने के बजाय बाहरी टिकाऊ स्टोर में बनी रहती है। यह एकल थ्रेड_आईडी/सत्र_आइड पर स्कोप किया गया है, ठीक वही जो इन-मेमोरी चेकपोइंटर कैप्चर करता है। फ्रेमवर्क आमतौर पर बाह्य अल्पकालिक स्मृति के लिए इन-मैमोरी सत्रों को बनाए रखते हैं।
दीर्घकालिक स्मृति, Databricks Managed Memory में, बातचीत के बजाय उपयोगकर्ता की पहचान द्वारा कुंजीबद्ध है। यह तथ्यों को किसी भी एक वार्तालाप से बाहर निकालकर जानकारी, वरीयताओं और पिछले निर्णयों को उपयोगकर्ताओं की पहचान के तहत निकालने देता है, इसलिए कल एक नया धागा उन्हें याद कर सकता है। अल्पकालिक मेमोरी इस बातचीत को याद करती है; लंबी अवधि की स्मृति इस उपयोगकर्ता को याद रखती है।
किसी उपयोगकर्ता को स्मृति का दायरा देने के लिए, सिस्टम को एक Identity Provider की आवश्यकता होती है जैसे कि ओक्टा या AWS Cognito; उपयोगकर्ता प्रमाणीकरण करता है, और परिणामस्वरूप OAuth / (OBO) token की ओर से सत्यापित अंतिम-उपयोगकर्ता पहचान रखता है।
निष्कर्षण और पुनर्प्राप्ति को डिजाइन कार्य की आवश्यकता है
मेमोरी लिखना एक सरल कॉल हो सकता है। memory_store.add कॉल actor_id="user-123", path="/preferences/communication.md", content="Prefers email over phone. Timezone: PST. Enterprise subscription"., और description="User 123 communication preferences". का उपयोग कर सकते हैं कठिन कार्य यह तय करना है कि कौन सी प्रासंगिक जानकारी को बनाए रखा जाना चाहिएः एजेंटों को दीर्घकालिक-प्रासंगिक तथ्यों को निकालना चाहिए और अप्रासंगिक छोटी बातचीत या एक बार के तथ्यों की अनदेखी करनी चाहिए।
जैसा कि अब तक जारी किया गया है, डेटाब्रिक्स प्रबंधित मेमोरी जहाजों में कोई अंतर्निहित निष्कर्षण रणनीतियाँ नहीं हैं; टीमें कस्टम रणनीतियों को परिभाषित करती हैं। Fully Managed Lakebase इसमें अंतर्निर्मित रणनीतियां शामिल हैंः सिमेंटिक टिकाऊ तथ्यों को खींचता है; सारांश एक सत्र-स्कोप्ड सारांश संग्रहीत करता है; User Preferences कैप्चर कैसे उपयोगकर्ता चीजों की तरह; एपिसोडिक, सबसे जटिल, विशिष्ट पिछली घटनाओं को रिकॉर्ड करता है। एजेंटकोर में, प्रत्येक रणनीति कच्चे ईवेंट स्ट्रीम पर चलाए जाने वाले एक निष्कासन प्रॉम्प्ट होती है। एपिसोडिक मेमरी यह पकड़ती है कि बातचीत में क्या हुआ, जैसे निर्णय लिया गया या समस्या हल हुई या संपर्क किया गया, इसलिए एजेंट इसे बाद में याद कर सकता है।
डेटाब्रिक्स के साथ, डेवलपर्स प्रत्येक रणनीति को लागू करते हैं। एक दृष्टिकोण उपकरण कॉल हैः एजेंट को एक कस्टम सेव_मेमोरी टूल दें और उसे यह तय करने दें कि कुछ मानक टूल फ्रंटमैटर, विवरण और कौशल का उपयोग करके रखने योग्य है। सामग्री, वर्णन और पथ सहित टूल का विवरण और स्कीमा मॉडल को बताता है कि इसे कब और कैसे बुलाया जाए; एक कौशल मार्गदर्शन जोड़ सकता है। दूसरा एक आसवन चरण हैः स्थायी तथ्यों को खींचने और उन्हें स्टोर में लिखने के लिए पूरे इंटरैक्शन पर एक अलग LLM कॉल या सिस्टम प्रॉम्प्ट।
पुनर्प्राप्ति तब होती है जब एक नया इंटरैक्शन लॉन्च होता है। एजेंट को व्यक्तिगत प्रतिक्रियाएं उत्पन्न करने के लिए प्रासंगिक मेमोरी खींचनी चाहिए। डेटाब्रिक्स प्राकृतिक भाषा खोज का उपयोग करता हैः actor_id="user-123" और path_prefix="/preferences/", फिर memory_store.search with actor _ id=" user-123", query="communication preferences", and limit=10. Databricks डॉक्स इंगित करते हैं कि यह BMBM25 पूर्ण-पाठ प्रासंगিকता है और शीर्ष-एन सेट (100 प्रविष्टियों तक) लौटाता है। 25] यह उसी तरह से मानक वेक्टर समानता खोज नहीं है AWS Agentcore स्मृति उपभोग करती है। चूंकि पुनः प्राप्त आइटम मॉडल के context window में इंजेक्ट किए जाते हैं, इसलिए सावधानीपूर्वक पुनर्प्राप्त करना आवश्यक है। सबसे अच्छा अभ्यास पहले सूची चलाना है, सभी स्मृति प्रविष्टियां वापस करें, और वर्तमान बातचीत के लिए आवश्यक प्रविष्टि निर्धारित करने के माध्यम से उन लोगों की खोज करें।
अगला क्या है
Unity Catalog से लेकबेस में स्विच परिचालन मान्यताओं को बदलता है। Managed Lakebase स्कीमा कार्य को कम करता है लेकिन कुछ नियंत्रण डेटाब्रिक्स पर स्थानांतरित कर देता है; स्व-प्रबंधित पोस्टग्रेस उन टीमों के लिए उपलब्ध रहता है जिन्हें डेटाबेस स्तर के स्वामित्व की आवश्यकता होती है। अंतर्निहित निष्कर्षण रणनीतियों की अनुपस्थिति का मतलब है कि मेमोरी गुणवत्ता डेवलपर द्वारा परिभाषित टूल, संकेत या आसवन चरणों पर निर्भर करती है। टीमों को यह तय करना चाहिए कि प्रत्येक तथ्य किस पहचानकर्ता का मालिक हैः वार्तालाप स्थिति के लिए थ्रेड / सत्र, स्थायी वरीयताओं के लिए उपयोगकर्ता / अभिनेता। उन्हें संदर्भ विंडो लागत की निगरानी भी करनी चाहिए, क्योंकि शीर्ष-एन पुनर्प्राप्ति 100 प्रविष्टियों तक वापस आ सकती है।
डेटाब्रिक्स का मेमोरी रोडमैप पूरी तरह से स्व-प्रबंधित Lakebase Postgres DB से प्रबंधित एजेंटिक मेमरी Unity Catalog में स्थानांतरित हो गया, और सितंबर 2026 के रूप में प्रबंधित पेशकश लेकबेस पर स्विच की गई। अंतर्निहित लेख मूल रूप से मध्यम पर Towards AI में प्रकाशित किया गया था।
Comments (0)