
JUST मिलान कीवर्ड के बजाय अर्थ को समझकर AI सिमेंटिक खोज कार्य करें।
यह मार्गदर्शिका बताती है कि embeddings शब्दार्थ AI खोज को कैसे सक्षम करता है, कीवर्ड स्टफिंग क्यों विफल हो जाता है और 768 और 1536 आयाम सटीकता और लागत को कैसे प्रभावित करते हैं।
मुख्य जानकारी
- सिमेंटिक खोज केवल सटीक कीवर्ड मिलान पर भरोसा करने के बजाय अर्थ और उपयोगकर्ता इरादे को समझने के लिए embeddings का उपयोग करती है, जो विफल हो जाती है जब लोग एक ही अनुरोध के लिए अलग-अलग वाक्यांशों का उपयोग करते हैं।
- embedding मॉडल पाठ को संख्यात्मक वेक्टरों में परिवर्तित करते हैं जो अर्थ का प्रतिनिधित्व करते हैं, जिससे समान वाक्यांश जैसे कि "मुझे धनवापसी प्राप्त करें" और "मैं अपना पैसा वापस चाहता हूं" वेक्टर स्पेस में एक साथ पाया जा सकता है।
- उच्च embedding आयाम अधिक प्रतिनिधित्व क्षमता प्रदान करते हैं, लेकिन वे स्वचालित रूप से बेहतर खोज गुणवत्ता का उत्पादन नहीं करते हैं; एक अच्छी तरह से प्रशिक्षित 768-आयामी मॉडल विशिष्ट कार्यों के लिए 1536-आयाम मॉडल को पार कर सकता है।
- embedding आयाम सीधे भंडारण और मेमोरी लागत को प्रभावित करते हैंः 768-आयामी फ्लोट 32 वेक्टर प्रति वेक्टर लगभग 3.1 केबी का उपयोग करते हैं, जबकि 1536-आयाम वाले वेक्टरों में लगभग 6.1 केबी की खपत होती है, जो बड़े पैमाने पर महत्वपूर्ण हो जाती है।
मेटा विवरणः यह AI पुनर्प्राप्ति व्याख्याकार दिखाता है कि कीवर्ड स्टफिंग सहायक के लिए विफल क्यों होता है और 768 और 1536 embedding आयाम सटीकता और स्मृति लागत को कैसे प्रभावित करते हैं।
टैगः AI पुनर्प्राप्ति, सिमेंटिक खोज, embedding आयाम, वेक्टर खोज, कीवर्ड खोज
विशेष रुप से प्रदर्शित छवि: (अंग्रेज़ी में) ">"</string> एक स्थान में निर्देशांक बिंदु बनने वाले वाक्यों का अमूर्त मैत्रीपूर्ण चित्रण, कोई लोग, लोगो या पाठ नहीं।
उत्पादन पुनर्प्राप्ति-Augmented Generation ( RAG ) प्रणालियों का निर्माण करने वाली टीमों के लिए, Production RAG Series का भाग 6 बताता है कि जब उपयोगकर्ता स्वाभाविक रूप से बोलते हैं तो कीवर्ड स्टफिंग क्यों विफल हो जाता है और embedding मॉडल कैसे सिमेंटिक खोज का समर्थन करते हैं। यह 768 और 1536 embedding आयामों और उनके भंडारण और RAM लागत की तुलना भी करता है।
पुरानी खोज की चाल अब मानव अनुरोधों से मेल नहीं खाती
भाग 5, Advanced RAG Chunking के बाद, अभिभावक-Document Retrieval, ब्रेडक्रंब्स और Contextual Retrieval के साथ दस्तावेजों को विभाजित करना शामिल है, भाग 6 पूछता है कि मेटाडेटा से समृद्ध टुकड़ों की खोज कैसे करें।
दशकों से, Elasticsearch और Solr ने शाब्दिक मिलान का उपयोग कियाः "रन", "रनिंग" और "रनर", श्रेणी फ़िल्टर और क्यूरेटेड पर्यायवाची सूचियों को जोड़ने के लिए स्टैमिंग। विक्रेताओं और रचनाकारों ने संबंधित शब्दों जैसे कि "Wireless Noise-Cancelling Over-Ear Headphones माइक्रोफोन के साथ [14 Bluetooth Travel Headset, 40-Hour Battery" और "Python Full Course शुरुआती लोगों के लिए 2026Learn Python 8 घंटों में ". ट्यूटोरियल निर्माता भी टैग जोड़ते हैं जैसे कि " Python ट्यूटोरियल" तथा "कोडिंग क्रैश कोर्स"। उपयोगकर्ताओं ने कीवर्ड-भारी वाक्यांश टाइप किए जैसे "बेस्ट कॉफी शॉप डाउनटाउन WiFi देर से खुला है।"
एक ग्राहक जो "हेडसेट" खोज रहा है, वह समानार्थी नियम या किसी अन्य संकेत के बिना "हैडफ़ोन" लेबल वाले उत्पाद से मेल नहीं खा सकता है। AI सहायकों ने पैटर्न को बदल दिया। लोग पूर्ण वाक्यों में पूछते हैं। लेख तीन अनुरोधों की तुलना एक इरादे के साथ करता हैः "मुझे धनवापसी प्राप्त करें", "मैं अपना पैसा वापस चाहता हूं" और "कृपया मेरे कार्ड पर शुल्क को उलट दें"। वे "रिफंड", "पैसा वापस" का उपयोग करते हैं और "चार्ज को उल्टा कर देते हैं।" इस शब्दावली असंगति का मतलब है कि सहायता केंद्र के लेख में कहा गया है कि जब तक पर्यायवाची या अन्य सिग्नल इसे पुल नहीं करते तब तक "धन वापसी" द्वारा छूट सकती है। उनके बिना परिणाम अप्रासंगिक हो सकते हैं, सही नीति नीचे दफन किया जा सकता है, या ग्राहक कुछ भी उपयोगी नहीं पा सकता है ।
टीमें मैन्युअल कीवर्ड स्टफिंग और हाथ से तैयार किए गए पर्यायवाची शब्दकोशों के साथ हर भिन्नता को कवर नहीं कर सकती हैं। स्लैंग, बोलचाल वाले वाक्यांश, मुहावरे, टाइपो और विभिन्न मानसिक मॉडल इसे असंभव बनाते हैं। अर्थपूर्ण खोज अर्थ और इरादे की तलाश करती है, न कि सटीक शब्द ओवरलैप।
embeddings वाक्यांशों को निर्देशांक में बदलें
दस साल का बच्चा जानता है कि दो वाक्यांशों का एक ही मतलब हो सकता है; कंप्यूटर में ऐसी अंतर्ज्ञान नहीं होती। यह अंग्रेजी, स्पैनिश या हिंदी नहीं बोलता और यह कुत्ता, सेब या धनवापसी के अनुरोध को स्वाभाविक रूप से समझ नहीं पाता है। यह एक गणना मशीन है, इसलिए वाक्यों की तुलना करने के लिए अर्थ को संख्याओं में बदलना आवश्यक है।
एक embedding मॉडल किताबों, लेखों, कोड और वेब वार्तालापों से अरबों वाक्यों पर प्रशिक्षित neural network है। यह कठोर व्याकरण नियमों के बजाय संदर्भ से संबंधों को सीखता है. यह पाठ को वेक्टर प्रतिनिधित्व में परिवर्तित करता है, संख्याओं की एक सूची जो अर्थ अंतरिक्ष में निर्देशांक की तरह कार्य करती है।
स्रोत एक मानसिक मॉडल के रूप में GPS का उपयोग करता हैः [अक्षांशः 37.7749 ° उत्तर, देशांतर: 122.4194 डिग्री पश्चिम] पर स्थित एक रेस्तरां और 37.7750, -122.4195] पर सड़क पार की एक कॉफी शॉप करीब हैं, जबकि टोक्यो दूर है। 880034 निर्देशांक भौतिक स्थानों का वर्णन करते हैं; embedding समन्वय भाषा पैटर्न का विवरण देते हैं, और व्यक्तिगत आयामों में सरल लेबल नहीं होते हैं।
नमूना वेक्टरों को वास्तविक मॉडल आउटपुट के बजाय चित्रणात्मक चिह्नित किया गया हैः "मैं अपना पैसा वापस चाहता हूं" [0.342, -0.715, 0.821, 0.154, ... 0.092]; "मुझे धनवापसी प्राप्त करें" [0.351, -0.702, 0.808, 0.149, ... 0.088];" मैं खमीर की रोटी कैसे बनाऊं? "[-0.884, 0.129, -0.453, - 0.612, ... -0.741. एक छोटा नमूना है [0.34], -0.71, 0.82, 0.15, -0.09, 0.63, ...]। पहले दो वैक्टर करीब हैं, यहां तक कि जब शब्द भिन्न होते हैं तो भी सिमेंटिक समानता दिखाते हैं।
अधिक आयाम कमरे को जोड़ते हैं, स्वचालित गुणवत्ता नहीं
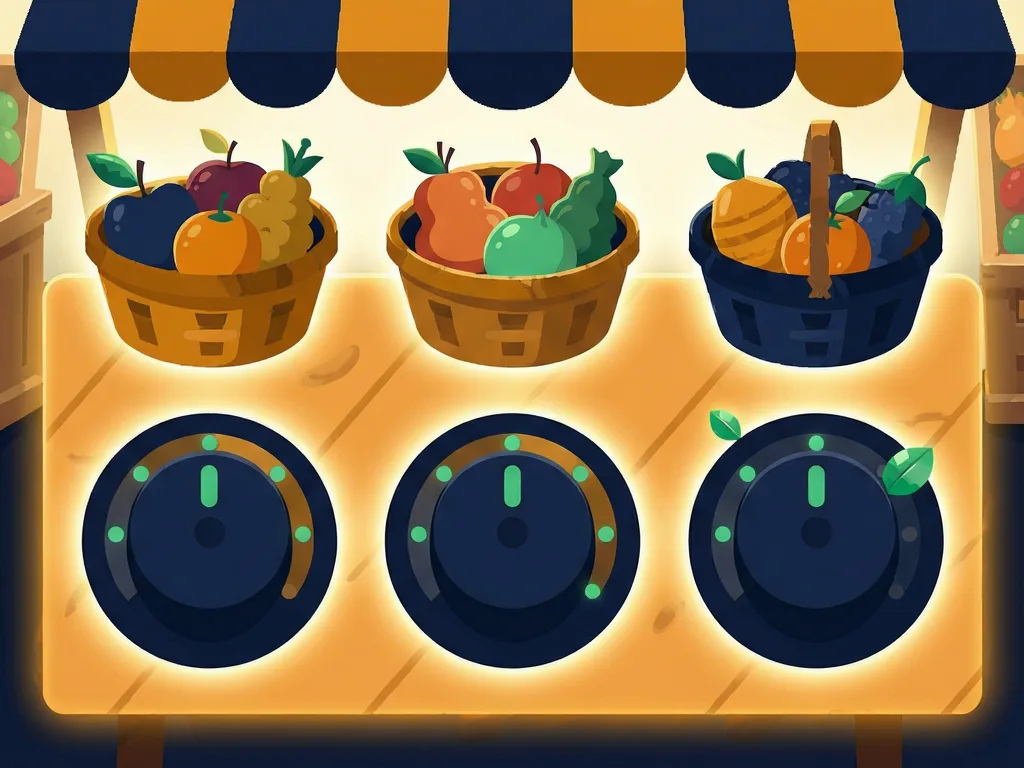
यदि लाल और हरे सेबों को अलग करना है, तो यह तीक्ष्णता को आयाम ४ के रूप में जोड़ देता है; रंग की रंगाई को आयाم ५ के तौर पर और रसदारपन को आयाમ ६.
सादृश्य से पता चलता है कि अधिक संख्याएं जानकारी का प्रतिनिधित्व करने के लिए अधिक जगह क्यों दे सकती हैं। वास्तविक embedding आयाम डेटा से सीखे जाते हैं और जरूरी नहीं कि भावना, औपचारिकता, तनाव, डोमेन, विषय या इरादे से मेल खाते हों। अधिक आयाम स्वचालित रूप से बेहतर शब्दार्थ समझ का मतलब नहीं है। एक सामान्य शुरुआती धारणा यह है कि 1536 दोगुना 768 है और इसलिए हमेशा बेहतर होता है। अच्छी तरह से प्रशिक्षित 768-आयामी मॉडल विशेष रूप से कानूनी दस्तावेजों, चिकित्सा कागजात, customer support प्रश्नों या e-commerce कैटलॉग्स के लिए एक विशिष्ट कार्य पर 1 आयामी मॉडल को पार कर सकता है।
768, 1536 और 3072 आयामों की अलग-अलग लागत होती है
सामान्य 768-आयामी मॉडल में bge-base, all-mpnet-base-v2 और e5-base- v2 शामिल हैं। आम 1536 आयामी मॉडलों में OpenAI text- embedding -3-small और text-8 embedding -- ADA -002 शामिल है। लेख यह भी नोट करता है कि text- embedding --3 large तक 3072 आयामों का उपयोग कर सकता है।
भंडारण गणित संख्यात्मक प्रारूप का पालन करता है। जब प्रत्येक संख्या को 32-बिट फ्लोटिंग-पॉइंट नंबर, या Float32 के रूप में संग्रहीत किया जाता है, तो एक संख्या 4 बाइट्स का उपयोग करती है। 768 आयामी वेक्टर की आवश्यकता 768 × 4 बायट्स = 3,072 बाइट, लगभग 3.1 KB होती है। 1536 -आयामी वैक्टर की जरूरतें 1536 × 4 बाईट = 6,144 बाइट , लगभग 6.1 KB । स्रोत प्रति-वेक्टर आकार को ~3.0 KB बनाम ~6.1 KB फ्रेम करता है. दोहरे आयाम उसी प्रारूप में प्रति वेक्टर मेमोरी दोगुना करते हैं।
तेजी से खोज के लिए, वेक्टरों को मेमोरी में रखने की आवश्यकता हो सकती है। 1,000,000 chunks के लिए कच्चे वेक्टर 768 आयामों पर लगभग RAM GB और 1536 आयाम पर 6.14 [50) पर कब्जा करते हैं। यदि कोई संगठन 20 मिलियन टुकड़ों का सूचकांक बनाता है, जैसे कि समर्थन टिकट, स्लैक संदेश, ईमेल और विकी, तो अकेले कच्चा 1536-आयामी वैक्टर फ्लोट 32 के रूप में संग्रहीत होने पर लगभग 122.88 [50) पर कब्ज़ा करेंगे। स्रोत नोट्स यह भंडारण और खोज करने के लिए पर्याप्त डेटा है, जबकि वास्तविक बुनियादी ढांचा डेटाबेस और इंडेक्स कॉन्फ़िगरेशन पर निर्भर करता है।
अगला निर्णय यह नहीं है कि सिमेंटिक खोज का उपयोग किया जाए, लेकिन वास्तविक पुनर्प्राप्ति कार्यों के खिलाफ परीक्षण करने के लिए कौन सा मॉडल आकार। टीमों को मूल्यांकन करना चाहिए कि अलग-अलग embedding आकार उनके एप्लिकेशन की आवश्यकताओं की जानकारी कैसे प्राप्त करते हैं, बजाय इसके कि वे मान लें 1536 768 से बेहतर है क्योंकि वेक्टर दोगुना लंबा है।
Comments (0)