
एक व्यावहारिक LangChain ट्यूटोरियल बताता है कि Portable Document Format फ़ाइलों में स्मार्ट वैज्ञानिक साहित्य खोज के लिए शर्लक कैसे बनाया जाए।
LangChain ट्यूटोरियल वैज्ञानिक Portable Document Format फ़ाइलों को सूचकांकित करता है, अर्थ के अनुसार मार्ग प्राप्त करता है और फाइलनाम और पृष्ठों का हवाला देता है।
मुख्य जानकारी
- Sherlock PDF एक लैंगचेन ट्यूटोरियल है जो उपयोगकर्ताओं को सादे भाषा के सवालों के साथ स्थानीय वैज्ञानिक पीडीएफ में खोज करने और फ़ाइल नाम और पृष्ठ संख्या के साथ प्रासंगिक मार्गों को पुनर्प्राप्त करने की अनुमति देता है।
- यह सिमेंटिक खोज का उपयोग करता हैः पीडीएफ पाठ को टुकड़ों में विभाजित किया जाता है, ओपनएआई के साथ एम्बेडिंग में परिवर्तित कर दिया गया है, वेक्टर डेटाबेस में संग्रहीत और कॉसिनस समानता से मेल खाता है।
- यह दृष्टिकोण कीवर्ड-खोज विफलताओं को दूर करने में मदद करता है जब याद किए गए वाक्यांश स्रोत शब्द से भिन्न होते हैं, जिससे कई कागजातों पर सबूत ढूंढना आसान हो जाता है।
- पाइथन 3.10+, ओपनएआई API कुंजी और डॉक्स फ़ोल्डर में रखे गए पाठ-आधारित पीडीएफ का उपयोग करके लगभग 15 मिनट में एक कामकाजी डेमो बनाया जा सकता है।
- ट्यूटोरियल में व्यावहारिक सीमाओं पर भी ध्यान दिया गया हैः स्कैन किए गए पीडीएफ को ओसीआर की आवश्यकता होती है, एम्बेडिंग के लिए PDF टेक्स्ट ओपनएआई को भेजा जाता है और गोपनीय फ़ाइलों को केवल तभी संसाधित किया जाना चाहिए जब डेटा नीति द्वारा अनुमति दी जाए।
शर्लक पीडीएफ ट्यूटोरियल 15 मिनट में वैज्ञानिक पत्रों के लिए लैंगचेन खोज बनाता है
मेटा विवरणः Build Sherlock PDF के साथ लैंगचेन वैज्ञानिक पीडीएफ खोज करने, फ़ाइल नाम और पृष्ठ संख्या द्वारा मार्गों को पुनः प्राप्त करने और OpenAI एम्बेडमेंट्स के साथ साक्ष्य सत्यापित करने के लिए।
टैगः लैंगचेन, पीडीएफ खोज, सिमेंटिक खोज, वैज्ञानिक साहित्य, ओपनएआई एम्बेडिंग
विशेष रुप से प्रदर्शित छवि: कागज के पन्नों और जुड़े डेटा बिंदुओं पर एक आवर्धक कांच का अमूर्त चित्रण, मैत्रीपूर्ण शैली, कोई वास्तविक लोग नहीं हैं, कोई लोगो नहीं है, कोई पाठ नहीं।
Sherlock PDF नामक एक लैंगचेन ट्यूटोरियल शोधकर्ताओं को दिखाता है कि सादे भाषा में प्रश्न कैसे पूछें और फ़ाइल नाम और पृष्ठ संख्या के साथ स्थानीय वैज्ञानिक पीडीएफ से सबसे अच्छे मिलान वाले मार्गों को वापस प्राप्त करें। यह किसी भी व्यक्ति के लिए है जिसने कागजात के ढेर के अंदर एक उपयोगी पैराग्राफ खो दिया है और इसे फिर से खोजने का एक पुनरुत्पादित तरीका चाहता है। पायथन 3.10 +, ओपनएआई API कुंजी और कुछ टेक्स्ट-आधारित पीडीएफ़ के साथ एक कामकाजी डेमो लगभग 15 मिनट लगते हैं।
शोधकर्ताओं को खोजशब्दों से अधिक की आवश्यकता क्यों है
वैज्ञानिक बड़ी मात्रा में जानकारी पढ़ते हैंः पेपर, प्रीप्रिंट्स, समीक्षाएं, पूरक फाइलें, प्रोटोकॉल और कभी-कभी final_version_REALLY_FINAL_2.4.pdf नाम के 87 पृष्ठों का पीडीएफ। सब कुछ पढ़ना मुश्किल है, लेकिन कठिन कार्य बाद में आता है। एक शोधकर्ता को याद हो सकता है कि किसी चीज़ पर चर्चा की गई थी, फिर भी यह याद नहीं कर सकते हैं कि किस कागज, किस पेज या किस पैराग्राफ में सबूत थे।
कीवर्ड खोज तब विफल हो सकती है जब याद किए गए शब्द स्रोत के शब्दों से भिन्न होते हैं। कई कागजात को फिर से खोलना और कुंजीशब्द संयोजनों का परीक्षण करना उस प्रयोग की तुलना में अधिक समय ले सकता है जिसने प्रश्न उठाया था। Sherlock PDF इस समस्या को हल करने के लिए खोज को सिमेंटिक पुनर्प्राप्ति में बदल देता हैः प्रश्न और मार्ग वेक्टर में परिवर्तित हो जाते हैं, फिर निकटतम मार्ग उनके मूल स्रोत स्थान के साथ वापस आ जाते हैं।
शर्लक पीडीएफ कैसे सबूत में बदलता है
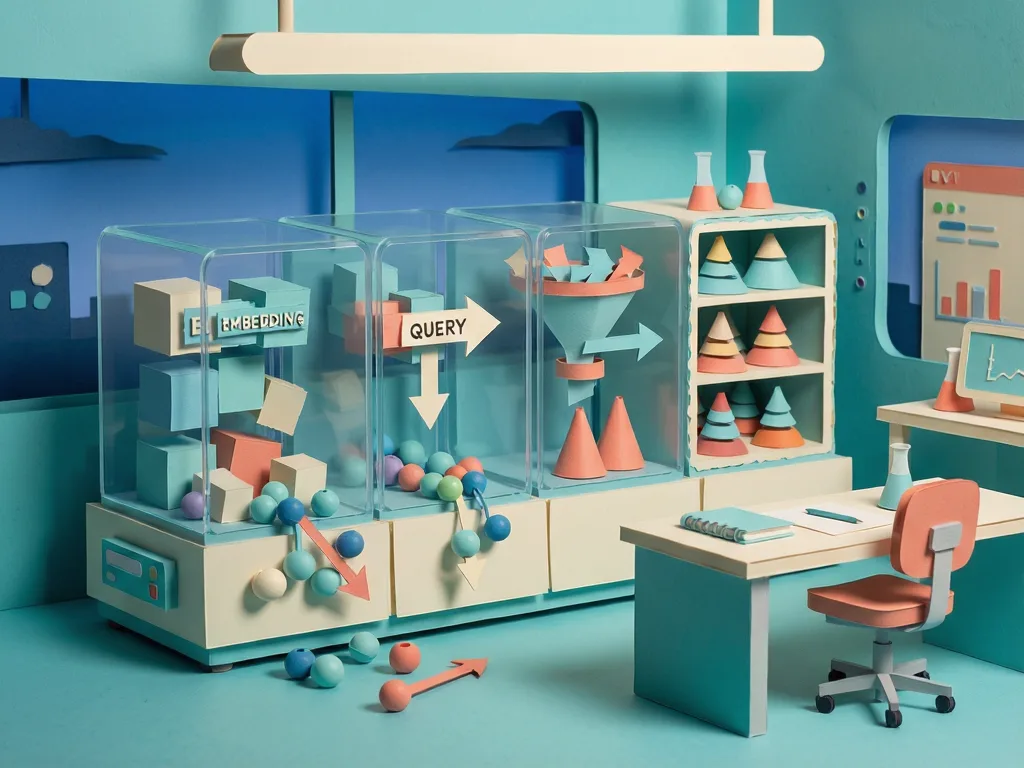
Sherlock PDF एक स्थानीय डॉक्स/फ़ोल्डर से प्रत्येक पीडीएफ लोड करके काम करता है, पृष्ठ द्वारा पाठ का निष्कर्षण करता है और उस टेक्स्ट को ओवरलैपिंग टुकड़ों में विभाजित करता है। प्रत्येक खंड मेटाडेटा जैसे फ़ाइल नाम और पेज नंबर रखता है। टुकड़े एम्बेडिंग में परिवर्तित हो जाते हैं, जो अर्थ के संख्यात्मक प्रतिनिधित्व होते हैं। उन एंबेडिंग्स को इन-मेमोरी वेक्टर स्टोर में संग्रहीत किया जाता है। जब कोई प्रश्न एम्बेडेड होता है, तो सिस्टम निकटतम मार्गों को पुनर्प्राप्त करता है.
ट्यूटोरियल एक नमूना क्वेरी के साथ विचार का प्रदर्शन करता हैः "नींद हिप्पोकैम्पल मेमोरी समेकन को कैसे प्रभावित करती है?" आउटपुट एक कॉम्पैक्ट साक्ष्य रिपोर्ट हैः
- 91। sleep_memory_study.pdf, पृष्ठ 5। प्रासंगिक अंश...
- 87। hippocampus_review.pdf, पेज 12। एक और प्रासंगिक अंश...
स्कोर कोसाइन समानता से आता है, एक सामान्य उपाय जो दो वैक्टरों की दिशा की तुलना करता है न कि उनकी लंबाई। सूत्र वेक्टर्स ए और बी के डॉट प्रोडक्ट का उपयोग करते हुए उनके लम्बाई के उत्पाद द्वारा विभाजित किया जाता है। 1 के करीब स्कोर का मतलब है कि वेक्टर बहुत समान दिशाओं में इंगित करते हैं। 0 के पास स्कोर कम दिशात्मक समानता का अर्थ है।
दो मार्गों का अर्थ सटीक शब्दों के बिना साझा किया जा सकता है। एक में मैला पदचिह्न, तंबाकू की राख और प्रयोगशाला कुंजी गायब हो सकती है। दूसरा जूते पर मिट्टी, सिगार अवशेष और प्रयोगशाला में अनधिकृत पहुंच का उल्लेख कर सकता है । शब्द अलग-अलग हैं, लेकिन सुराग लगभग उसी दिशा में इशारा करते हैं। ग्रंथसूची को प्रारूपित करने के बारे में एक मार्ग पूरी तरह से कहीं और इंगित करता है।
अर्थपूर्ण खोज का व्यावहारिक मूल्य यही है। यह किसी प्रश्न को एक प्रासंगिक पैराग्राफ से जोड़ सकता है, भले ही पैराग्राफ़ अलग-अलग शब्दावली का उपयोग करता हो। पृष्ठ संख्या भी मायने रखती है। एक विश्वसनीय उत्तर उपयोगी है, लेकिन ऐसा अंश जो पाया जा सके, संदर्भ में पढ़ा जाए और सत्यापित किया जा सके वह अधिक उपयोगी है।
परियोजना का एक-एक करके निर्माण
- परियोजना प्राप्त करें. https://github.com/suvrazastrovision/langchain_demo.git पर रिपॉजिटरी को क्लोन या डाउनलोड करें, फिर cd path\to\langchain_demo के साथ डाउनलोड किए गए प्रोजेक्ट फ़ोल्डर में बदलें।
- एक आभासी वातावरण बनाएँ. PowerShell में, python -m venv .venv चलाएँ और फिर .\.venv\Scripts\Activate.ps1. macOS या लिनक्स पर, Python3 -m Venv .Venv चलाएं और उसके बाद स्रोत .VENV/bin/activate.
- निर्भरताएँ स्थापित करें। python -m pip install -r requirements.txt चलाएं। परियोजना पीडीएफ लोड करने के लिए langchain-community, दस्तावेज़ों और वेक्टर स्टोर के लिए लैंगचेन-कोर का उपयोग करती है, OpenAI एम्बेडिंग के लिए लँगचैन-ओपेनाई, खोज योग्य टुकड़े बनाने के लिए लेंगचेन टेक्स्ट स्प्लिटर्स, पीडीएफ़ प्रसंस्करण के लिए pymupdf और pypdf, और पर्यावरण चर लोड होने के लिए पायथन-डोटेनवी का उपयोग करता है।
- OpenAI API कुंजी जोड़ें. प्रोजेक्ट डायरेक्टरी में एक .env फ़ाइल बनाएँ और एक OPENAI_API_KEY पंक्ति पर API कुंजी रखें। उस फाइल को कमिट न करें या सार्वजनिक रूप से कुंजी साझा न करें। रिपॉजिटरी पहले से ही . env के माध्यम से .gitignore को बाहर करती है.
- एम्बेडिंग मॉडल चुनें. Sherlock PDF एक छोटा सा डेमो है, इसलिए यह टेक्स्ट-एम्बेडिंग-3-स्माल का उपयोग करता है। एम्बेडमेंट्स पाठ को संख्यात्मक वैक्टर में परिवर्तित करते हैं ताकि संबंधित प्रश्न और मार्गों को तब भी पाया जा सके जब वे अलग-अलग शब्दावली का उपयोग करें। OpenAI इनपुट टोकन की संख्या के अनुसार अनुरोधों को बिल देता है। कुछ कागजात एम्बेडेड करने पर केवल सेंट खर्च होते हैं।
- वैज्ञानिक कागजात जोड़ें. डॉक्स निर्देशिका के अंदर एक या अधिक पाठ-आधारित पीडीएफ रखें। डेमो nature_emm.pdf, nn_ad.pdf और nn_sleep.pdf का उपयोग करता है। लेखक ने नोट किया कि इनमें प्रकृति से कुछ वैज्ञानिक पत्रिका लेख शामिल हैं। स्कैन किए गए दस्तावेजों में केवल छवियों को उनके टेक्स्ट की खोज करने से पहले ओसीआर चरण की आवश्यकता होती है। यह भी याद रखें कि एम्बेडिंग बनाने के लिए पीडीएफ़ टेक्स्ट OpenAI API पर भेजा जाता है, इसलिए गोपनीय या अप्रकाशित दस्तावेज़ों को तभी संसाधित किया जाना चाहिए जब संगठन की डेटा नीति इसकी अनुमति देती हो।
- एक शोध प्रश्न चुनें। sherlock_pdf.py खोलें और main में क्वेरी को संपादित करें) । डिफ़ॉल्ट डेमो सवाल हैः "डोरसल फैन-आकार के बॉडी न्यूरॉन्स के बीच अवरोधक ग्लूटामेटरजिक सिनैप्स धीमी गति से तरंग गतिविधि कैसे उत्पन्न करते हैं और ड्रोसोफिला में नींद के दबाव को विनियमित करते हैं?" लेखक छोटी पूछताछ भी दिखाता हैः "नींद हिप्पोकैम्पल मेमोरी समेकन को कैसे प्रभावित करती है?
- परिणामों की संख्या को नियंत्रित करें. पुनर्प्राप्ति कॉल डिफ़ॉल्ट रूप से top_k=3 का उपयोग करता है. पांच अंश के लिए, कॉल को top_ k=5 में बदलें। कोड को अमान्य मान जैसे गैर-पूर्णांक, बूलियन मान या शून्य से कम या बराबर संख्याओं को अस्वीकार करना चाहिए.
- Run Sherlock PDF. परियोजना फ़ोल्डर से पायथन sherlock_pdf.py चलाएँ.
- यह समझें कि पर्दे के पीछे क्या होता है। PyMuPDFLoader हर पीडीएफ पेज से टेक्स्ट और मेटाडेटा निकालता है। RecursiveCharacterTextSplitter पृष्ठों को छोटे, ओवरलैपिंग टुकड़ों में विभाजित करता है जिसमें chunk_size=220, Chunk_overlap=40, और विभाजक जैसे "\n\n", " \n ", " , and " । OpenAIEmbeddings प्रत्येक खंड को एक संख्यात्मक वेक्टर में परिवर्तित कर देता है। InMemoryVectorStore वेक्टर्स को संग्रहीत करता है और उन्हें प्रश्न के साथ तुलना करता है। सबसे अच्छा मिलान उनके मूल फ़ाइल नाम और पृष्ठ नंबर के साथ वापस आ जाता है।
सैद्धांतिक रूप से, पाइपलाइन हैः पीडीएफ को पृष्ठों में पाठ के टुकड़ों में एम्बेड करने के लिए समानता खोज सबूत। पेज मेटाडेटा खंडित होने पर जीवित रहता है। क्योंकि PyMuPDF नंबर शून्य से शुरू होते हैं, Sherlock PDF पृष्ठ संख्या प्रदर्शित करने से पहले एक जोड़ता है।
सटीक शब्दों के बजाय शब्दार्थ खोज का परीक्षण करना
ट्यूटोरियल अलग-अलग शब्दों के साथ एक ही प्रश्न पूछने का सुझाव देता हैः "क्या नींद हिप्पोकैम्पल कनेक्शन को कमजोर बनाती है?" कीवर्ड खोज में एक पैराग्राफ याद आ सकता है जो कहता है, "सीए 3 में धीमी तरंगों वाली नींद के दौरान सिनैप्टिक डाउनस्केलिंग होता है।" सिमेंटिक खोज अभी भी दोनों को जोड़ सकती है क्योंकि वे संबंधित अवधारणाओं पर विभिन्न शब्दावली में चर्चा करते हैं।
सीमाएँ और आगे के कदम
वेक्टर स्टोर प्रत्येक रन पर पुनर्निर्मित किया जाता है. यह एक छोटे से डेमो के लिए ठीक है, लेकिन हजारों कागजात को क्रोमा, FAISS, पाइनकोन या पोस्टग्रेएसक्यूएल जैसे पीजीवेक्टर के साथ निरंतर भंडारण की आवश्यकता होती है। लेखक का कहना है कि स्थायी संग्रहण अगले ट्यूटोरियल का विषय है।
पुनःप्राप्ति वैज्ञानिक सत्य की स्थापना नहीं करती है। स्कोर पाठक को बताता है कि कहां देखना है। पाठक को अभी भी उद्धृत पृष्ठ खोलना चाहिए और विधियों, संदर्भ और सीमाओं की जांच करनी चाहिए। Sherlock PDF एक पुनर्प्राप्त सहायक है, न कि सच्चाई मशीन। यह साक्ष्य खोजने में मदद करता है, लेकिन व्याख्या और सत्यापन शोधकर्ता का काम रहता है।
एक ही पाइपलाइन को स्केल किया जा सकता है जब दस्तावेज़ों को लगातार वेक्टर डेटाबेस में अनुक्रमित किया जाता है। लेखक, वर्ष, जर्नल या विषय के लिए फ़िल्टर इसे प्रयोगशाला के लिए अधिक उपयोगी बना सकते हैं। साझा खोज योग्य अनुसंधान स्मृति एक संभावित परिणाम है।
एंडनोट या मेंडली की तुलना में, Sherlock PDF एक संकीर्ण काम जीतता हैः प्राकृतिक भाषा का प्रश्न पूछना और फ़ाइल नाम और पृष्ठ संख्या के साथ अर्थशास्त्र से संबंधित मार्ग प्राप्त करना। लेकिन एंडनॉट और मेंडले संदर्भों को इकट्ठा करने, पीडीएफ एनोटेटिंग, सहयोग करने और ग्रंथसूची बनाने के लिए परिपक्व उपकरण हैं। डेमो ऐसा कुछ नहीं करता है। तुलना शब्दार्थ साक्ष्य पुनर्प्राप्ति बनाम संदर्भ प्रबंधन है। वाटसन मामले की फाइलों का प्रबंधन करती है; शर्लक वैचारिक सुरागों का पालन करती है।
मूल ट्यूटोरियल Towards AI में मीडियम पर प्रकाशित किया गया था, जहां पाठक बातचीत जारी रख सकते हैं।
आम गलतियाँ
एक आम गलती यह मान रही है कि उपकरण ओसीआर के बिना स्कैन किए गए पीडीएफ को खोज सकता है। यदि PDF में केवल छवियां हैं, तो एम्बेडिंग बनाने से पहले इसका पाठ निकाला जाना चाहिए।
एक और गलती .env फ़ाइल को प्रतिबद्ध करना है. OpenAI API कुंजी स्थानीय पर्यावरण फ़ाइल में होती है जिसे रिपॉजिटरी में नहीं धकेला जाना चाहिए।
एक तीसरी गलती स्कोर को सबूत के रूप में मानने की है। 0.91 का स्कोर कोई वैज्ञानिक निर्णय नहीं है। यह किसी ऐसे मार्ग की ओर इशारा करता है जिसे खोला, पढ़ा और जांचना चाहिए।
एक चौथी गलती डेमो को लगातार डेटाबेस की तरह व्यवहार करने की उम्मीद कर रही है। वेक्टर स्टोर हर रन के साथ फिर से बनाया जाता है. बड़े दस्तावेज़ संग्रहों के लिए, इन-मेमोरी पुनर्प्राप्ति पर भरोसा करने के बजाय निरंतर वेक्टर भंडार का उपयोग करें।
एक पांचवीं गलती top_k को अमान्य मान में बदल रही है. कोड सकारात्मक पूर्णांक की अपेक्षा करता है. गैर-पूर्णाङ्क, बूलियन और शून्य से कम या उसके बराबर मूल्यों को भ्रामक परिणामों के बजाय त्रुटि उत्पन्न करनी चाहिए।
छठी गलती पेज ऑफसेट को भूल जाना है। PyMuPDF शून्य-आधारित पृष्ठ सूचकांक संग्रहीत करता है। Sherlock PDF एक जोड़ता है ताकि प्रदर्शित पृष्ठ संख्या उस पृष्ठ से मेल खाती हो जिसे पाठक पीडीएफ में खोल सकता है।
एक सातवीं गलती कीवर्ड-खोज अपेक्षाओं का उपयोग कर रही है। यदि प्रश्न "कमजोर" कहता है, लेकिन कागज "डाउनस्केलिंग", सिमेंटिक खोज अभी भी प्रासंगिक मार्ग पा सकता है। मूल्य यह नहीं है कि शब्द मेल खाते हैं, बल्कि इसका अर्थ सबूत को पुनः प्राप्त करने के लिए पर्याप्त करीब है।
Comments (0)