
इस मुफ़्त Model Context Protocol सुरक्षा पाठ्यक्रम के साथ अपने AI एजेंटों को सुरक्षित रखें।
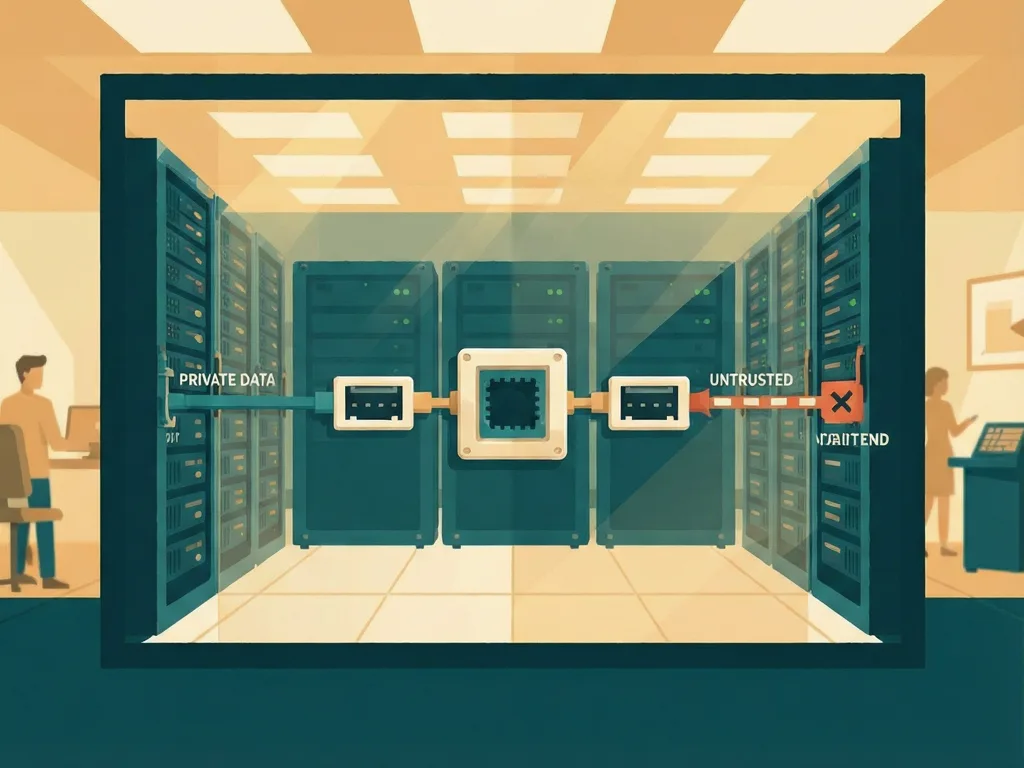
यह निःशुल्क पाठ्यक्रम निजी डेटा, अविश्वसनीय इनपुट और आउटबाउंड चैनलों के माध्यम से AI एजेंट जोखिमों की व्याख्या करता है, और वास्तुकला उन्हें कैसे अलग कर सकती है।
मुख्य जानकारी
- freeCodeCamp.org ने LLMs को बाहरी उपकरणों, डेटाबेस और APIs से जोड़ने के लिए Model Context Protocol का उपयोग करने वाले डेवलपर्स के लिए एक मुफ्त 2-घंटे MCP Security Fundamentals पाठ्यक्रम जारी किया।
- MCP -संचालित AI एजेंट नए सुरक्षा जोखिमों का परिचय देते हैं क्योंकि गैर-निर्णयवादी एजेंट अविश्वसनीय सामग्री पर कार्य कर सकते हैं और कमांड इंजेक्शन, विशेषाधिकार वृद्धि या token रिसाव को ट्रिगर करते हैं।
- पाठ्यक्रम का उपयोग करता है Simon Willison.s Lethal Trifecta framework फ्रेमवर्कः निजी डेटा एक्सेस, अविश्वसनीय सामग्री सेवन और बाहरी संचार प्रॉम्प्ट-संचालित शोषण के लिए एक खतरनाक हमला पथ बनाते हैं।
- अनुशंसित रक्षा वास्तुशिल्प पृथक्करण है, न कि JUST संकेत फ़िल्टरः विभाजित क्षमताएं ताकि कोई भी एजेंट निजी डेटा तक नहीं पहुंच सके, अविश्वसनीय सामग्री को संसाधित कर सके और एक ही समय में डेटा बाहर भेज सके।
- पाठ्यक्रम इस बात पर जोर देता है कि MCP एजेंट सुरक्षा उपकरण सुरक्षा, अनुमति डिजाइन और डेटा-प्रवाह नियंत्रण पर निर्भर करती है, न केवल मॉडल सुरक्षा।
मेटा विवरणः freeCodeCamp.org ने अपने YouTube चैनल पर 2-घंटे MCP Security Fundamentals Course प्रकाशित किया, जिसमें Lethal Trifecta एजेंट शोषण और रक्षा का उपयोग करना शामिल है।
टैगः MCP सुरक्षा, AI एजेंटों, त्वरित इंजेक्शन, freeCodeCamp, घातक त्रिपक्षीय
विशेष रुप से प्रदर्शित छवि: अमूर्त, मैत्रीपूर्ण चित्रण शैली जिसमें कोई वास्तविक लोग नहीं हैं, कोई लोगो और कोई पाठ नहीं है, एक छोटे स्वायत्त एजेंट को सुरक्षित तिजोरी, एक खुले इनबॉक्स और एक आउटगोइंग संदेश पाइप को जोड़ते हुए दिखा रहा है, जबकि एक ढाल एजेन्ट को अविश्वसनीय सामग्री से अलग करता है।
क्या freeCodeCamp प्रकाशित किया
2 घंटे की घड़ी डेवलपर्स और टीमों के लिए बनाई गई है, जो large language models या LLMs को बाहरी टूल, डेटाबेस और एप्लिकेशन programming इंटरफेस से कनेक्ट करने के लिए उपयोग करते हैं।
मूल चेतावनी सरल हैः MCP AI एजेंटों को अधिक उपयोगी बनाता है क्योंकि यह उन्हें मॉडल के बाहर कार्य करने के तरीके देता है। वही उपयोगिता एक नई सुरक्षा समस्या पैदा करती है। एक एजेंट जो संवेदनशील जानकारी पढ़ सकता है, अविश्वसनीय सामग्री स्वीकार कर सकता है और डेटा कहीं और भेज सकता है यदि उन क्षमताओं को सावधानीपूर्वक अलग नहीं किया जाता है तो हानिकारक व्यवहार में निर्देशित किया जा सकता है।
क्यों एजेंट सुरक्षा पारंपरिक अनुप्रयोग सुरक्षा से अलग है
पारंपरिक एप्लिकेशन सुरक्षा आमतौर पर निर्धारित कोड और अनुमानित इंटरैक्शन के आसपास बनाई जाती है। एक डेवलपर एक फ़ंक्शन लिखता है, इसके इनपुट को नियंत्रित करता है, और ज्ञात परिणाम की उम्मीद करता है। यहां तक कि जब कोई मानव या मशीन ऐप का उपयोग करती है, तो नियम ज्यादातर कोड द्वारा तय किए जाते हैं।
AI एजेंट उस मॉडल को बदलते हैं। एक गैर-निर्णयवादी निर्णय निर्माता एप्लिकेशन तर्क में प्रवेश करता है। एजेंट एक पृष्ठ, email , टिकट, मुद्दा या स्कीमा पढ़ सकता है, फिर यह तय कर सकता है कि किस उपकरण को कॉल करना है और कौन सा डेटा पास करना है। वह निर्णय लेने की प्रक्रिया उपयोगी है, लेकिन इसका मतलब यह भी है कि क्लासिक बग नए स्थानों पर दिखाई दे सकते हैं।
पाठ्यक्रम कमांड इंजेक्शन, विशेषाधिकार वृद्धि और token रिसाव को जोखिम के रूप में उजागर करता है जब कोई एजेंट अविश्वसनीय डेटा पर कार्य करता है। खतरा न केवल यह है कि एक दोष मौजूद है, बल्कि एक एजेंट सिस्टम के माध्यम से जल्दी से आगे बढ़ सकता है, जिससे छोटी इनपुट समस्या व्यापक परिचालन विफलता में बदल जाती है।
घातक त्रिपक्षीय ढांचा
पाठ्यक्रम के दौरान, डैन एजेंट शोषण को Simon Willisons Lethal Trifecta ढांचे के आसपास फ्रेम करता है। यह ढांचा तीन क्षमताओं के खतरनाक संयोजन का वर्णन करता है जो एक साथ मौजूद होने पर एक AI एजेंट को संरचनात्मक रूप से प्रॉम्प्ट-संचालित शोषण के लिए कमजोर बना सकता है।
निजी डेटा
पहली क्षमता निजी डेटा तक पहुंच है। इसमें संवेदनशील आंतरिक रिकॉर्ड, source code , क्रेडेंशियल या निजी डेटाबेस शामिल हो सकते हैं। इस एक्सेस के साथ एक एजेंट ऐसी जानकारी प्राप्त कर सकता है जो बाहरी उपयोगकर्ताओं या अविश्वसनीय इनपुटों को दिखाई नहीं देनी चाहिए।
अविश्वसनीय सामग्री
दूसरी क्षमता अविश्वसनीय सामग्री का सेवन है। पाठ्यक्रम वेब पृष्ठों, ईमेल, ग्राहक टिकट, सार्वजनिक मुद्दों और तृतीय-पक्ष उपकरण योजनाओं को उदाहरण के रूप में सूचीबद्ध करता है। इन स्रोतों में ऐसे निर्देश हो सकते हैं जिनका पालन नहीं किया जाना चाहिए, लेकिन एक एजेंट अभी भी उन्हें कार्यों के लिए व्याख्या कर सकता है।
बाहरी संचार
तीसरी क्षमता बाहर की ओर संचार करने की क्षमता है। पाठ्यक्रम वेबहॉक, मार्कडाउन रेंडरिंग, ईमेल और API कॉल को सिस्टम छोड़ने के लिए संभावित रास्तों के रूप में पहचानता है। यदि कोई एजेंट जानकारी को बाहर भेज सकता है, तो इन चैनलों में से एक के माध्यम से निजी डेटा उजागर किया जा सकता है।
कैसे पाठ्यक्रम एजेंटों की रक्षा का सुझाव देता है
मुख्य रक्षात्मक विचार वास्तुशिल्प सीमाओं के माध्यम से त्रिपक्षीय को तोड़ना है। पाठ्यक्रम का तर्क है कि टीमों को केवल नाजुक संकेत फ़िल्टर पर भरोसा नहीं करना चाहिए। एक प्रॉम्प्ट एजेंट को बता सकता है कि इससे क्या बचा जाए, लेकिन आर्किटेक्चर डिजाइन द्वारा कुछ कार्यों को असंभव बना सकता है।
इसका मतलब है कि एजेंट की निजी डेटा तक पहुंच को अविश्वसनीय सामग्री तक उसकी पहुँच से अलग करना और डेटा को बाहर भेजने की क्षमता से। यदि एक एजेंट एक बार में तीनों क्षमताओं को नहीं रख सकता है, तो हमले का मार्ग पूरा करना कठिन हो जाता है। पाठ्यक्रम शोषण के यांत्रिकी के माध्यम से चलता है और फिर बचाव पर ध्यान केंद्रित करता है जो सामान्य सामग्री को छिपे हुए निर्देश बनने की संभावना को कम करते हैं।
पाठक इस रिलीज से क्या सीख सकते हैं
MCP एकीकरण बनाने वाले पाठकों के लिए, यह कोर्स एक व्यावहारिक अनुस्मारक है कि AI एजेंट सुरक्षा JUST मॉडल की सुरक्षा नहीं है। यह उपकरण सुरक्षा, अनुमति डिजाइन और डेटा-प्रवाह नियंत्रण भी है। MCP का मूल्य यह है कि यह LLMs को वास्तविक प्रणालियों से जोड़ता है। जोखिम यह हैं कि उन सिस्टमों में साइड इफेक्ट्स, रहस्य और संचार मार्ग हो सकते हैं।
freeCodeCamp.org YouTube चैनल पूर्ण 2-घंटे के पाठ्यक्रम को मुफ्त में प्रदान करता है, जिससे टीमों को अपने स्वयं AI एजेंट एकीकरण को सख्त करने से पहले एजेंट शोषण पैटर्न की समीक्षा करने का एक संरचित तरीका मिलता है।
Comments (0)