
Profiling TorchNeuron Part 1 AWS Trainium पर सिस्टम-स्तरीय प्रोफाइलिंग को कवर करता है।
TorchNeuron के साथ AWS Trainium पर PyTorch अनुमान को प्रोफाइल करना सीखें, key_averages पढ़ें और Neuron Explorer में RMSNorm ट्रेस का निरीक्षण करें।
मुख्य जानकारी
- TorchNeuron, torch.profiler और Neuron Explorer का उपयोग करके PyTorch inference को प्रोफाइल करने के लिए एक शुरुआती-अनुकूल वर्कफ़्लो पेश करता है ताकि यह पता लगाया जा सके कि समय कहाँ बिताया जाता है।
- बताता है कि कैसे Neuron PrivateUse1 एक्सटेंशन प्वाइंट के माध्यम से PyTorch के साथ एकीकृत होता है, जिसमें NeuronConfig और NeuronProfiler डेटा स्ट्रीम को नियंत्रित करते हैं, न्यूरॉनकोर्स, ट्रेस निर्यात और डिवाइस-टाइम सहसंबंध।
- प्रोफाइलर सेटअप के व्यावहारिक चरणों की रूपरेखा देता है, जिसमें शामिल हैं ProfilerActivity.PrivateUse1, एक प्रतीक्षा/वर्म-अप/सक्रिय अनुसूची, torch.neuron.synchronize), और Neuron Explorer पर ट्रेस अपलोड करना।
- RMSNorm कार्यान्वयन की तुलना करके और key_averages का उपयोग करके कार्यप्रवाह को दर्शाता है ताकि न्यूरॉन डिवाइस समय को रैंक किया जा सके, फिर फ़्रेमवर्क डिस्पैच से लेकर रनटाइम शेड्यूलिंग और हार्डवेयर निष्पादन तक aten::mul जैसे ऑपरेशनों पर नज़र रखी जाए।
Meta Description: सीखें कि टॉर्च न्यूरॉन के साथ AWS Trainium पर पाइटॉर्क अनुमान को कैसे प्रोफाइल किया जाए, key_averages टेबल पढ़ें और Neuron Explorer में ऑपरेशन का पालन करें।
टैगः PyTorch, AWS Trainium, TorchNeuron, न्यूरॉन एक्सप्लोरर, अनुमान प्रोफाइलिंग
विशेष रुप से प्रदर्शित छवि: प्रोफाइलर लेनों के माध्यम से बहने वाले मॉडल ट्रेस का अमूर्त मैत्रीपूर्ण चित्रण, जिसमें कोई लोग, लोगो या पाठ नहीं है।
प्रोफाइलिंग श्रृंखला के भाग 1 में मशीन-लर्निंग प्रैक्टिशनरों को दिखाया गया है कि गहरी शिक्षा प्रशिक्षण और अनुमान कार्यभार के लिए एक उद्देश्य से निर्मित चिप AWS Trainium पर निष्कर्षण प्रदर्शन का व्यवस्थित रूप से विश्लेषण कैसे किया जाए। यह बताता है कि PyTorch inference की प्रोफ़ाइल कैसे करें, TorchNeuron, torch.profiler और Neuron Explorer के साथ एक साफ ट्रेस कैप्चर करें, और पता लगाएं कि समय कहाँ बिताया जाता है। वॉकथ्रू कोई प्रोफाइलिंग पृष्ठभूमि से शुरू नहीं होता है और तीन RMSNorm कार्यान्वयन की तुलना करता हैः अलग-अलग पायटोर ऑपरेशंस, टॉर्च.आरएमएस_नॉर्म), और टॉर्च कॉम्पाइल के साथ समान सरल संचालन अनुक्रम। स्क्रिप्ट उसी इनपुट, प्रोफायलर कॉन्फ़िगरेशन और शेड्यूल का उपयोग करती हैं, इसलिए परिणाम सीधे तुलनीय होते हैं, और वे टॉर्च-न्यूरॉन उदाहरण निर्देशिका में उपलब्ध हैं।
कोर सेटअपः Neuron को PyTorch से कनेक्ट करें और प्रोफाइलर कॉन्फ़िगर करें
Neuron PrivateUse1 एक्सटेंशन प्वाइंट के माध्यम से PyTorch के साथ एकीकृत होता है। cuda जैसे एक समर्पित डिस्पैच कुंजी को जोड़ने के बजाय, यह मार्ग फ्रेमवर्क के साथ एक त्वरक रजिस्टर करने की अनुमति देता है। टॉर्च_न्यूरोनक्स पैकेज न्यूरॉन को पायटोर्क कोड के लिए एक देशी बैकएंड बनाने के लिए अपस्ट्रीम पाइटॉर्च के साथ काम करता है; अधिक विवरण प्राइवेटयूस 1 द्वारा Facilitating New Backend Integration में दिखाई देते हैं। TorchNeuron Trainium पर मानक पायटोर्च वर्कफ़्लोज़ को सामान्य उपयोग के करीब रखता है, जिसमें उत्सुक निष्पादन, torch.compile और न्यूनतम कोड परिवर्तनों के साथ मानक PyTorch APIs शामिल हैं। यह ट्रेनीयन हार्डवेयर पर कस्टम ऑपरेटरों और प्रदर्शन अनुकूलन के लिए Neuron Kernel Interface से भी जुड़ता है।
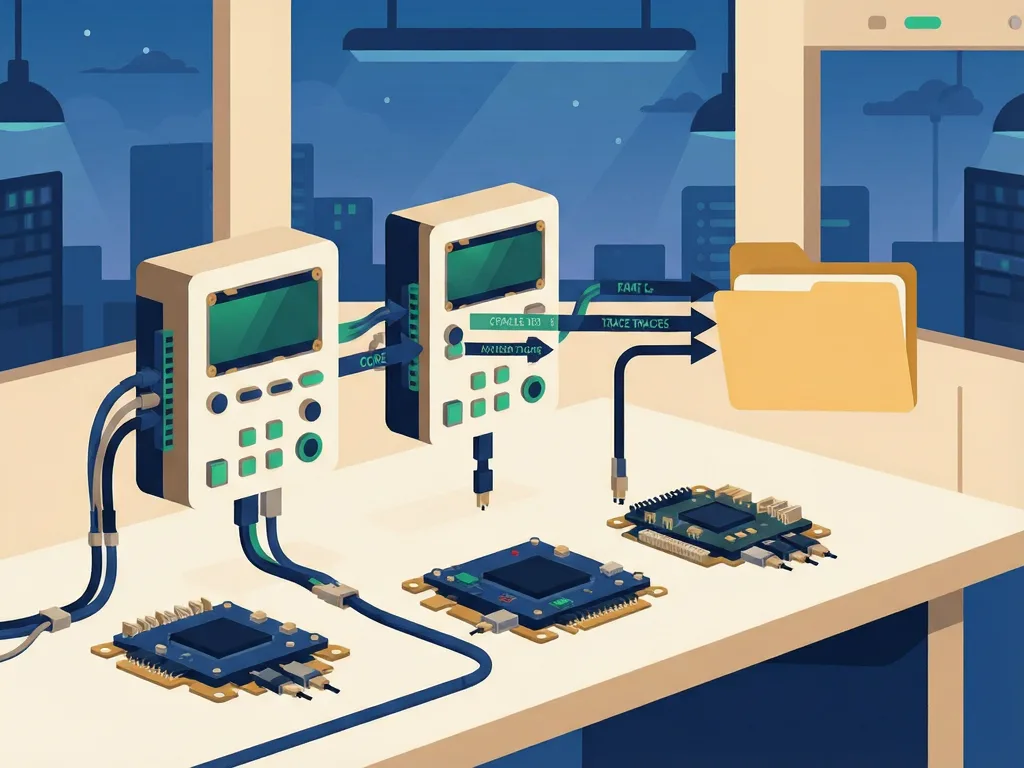
दो ऑब्जेक्ट प्रोफाइल को चलाते हैं। न्यूरॉनकॉन्फिग चुनता है कि कौन सी न्यूरन डेटा स्ट्रीम और न्यूरोनकोर्स कैप्चर किए जाते हैं और जहां आउटपुट लिखा जाता है। यह experimental_config के रूप में torch.profiler.profile पर पारित किया जाता है NeuronProfiler एक NeuronConfig प्राप्त करता है और export_trace कॉलबैक प्रदान करता है जो फ्रेमवर्क ट्रेस, trace.json लिखता है, न्यूरॉन्स सिस्टम ट्रेसेस के बगल में।
प्रोफाइलर सेटअप इन चरणों का अनुसरण करता हैः
- एक न्यूरॉन कॉन्फिग बनाएं। मोड पैरामीटर डेटा स्ट्रीम जैसे डिवाइस निर्देश और रनटाइम ट्रेस चुनता है, जबकि capture_enabled_for_nc ट्रैक करने के लिए NeuronCores का चयन करता है। पूर्ण मापदंडों और उपलब्ध प्रोफाइलमोड मूल्यों के लिए NeuronConfig Profile Modes प्रलेखन देखें।
- सेट correlate_device_time=True. यह ट्रेस से डिवाइस समय को key_averages में प्रसारित करता है, इसलिए Self CPU समय और न्यूरॉन डिवाइस समय की तुलना एक ही तालिका में की जा सकती है।
- Neuron डिवाइस से गतिविधि एकत्र करने के लिए ProfilerActivity.PrivateUse1 के साथ प्रोफाइलर को कॉल करें, और न्यूरॉन-विशिष्ट Kineto सुविधाओं को सक्षम करने के लिये experimental_config के रूप में NeuronConfig पास करें।
- wait=2, warmup=1, और active=1 के साथ चार prof.step() कॉल का उपयोग करें। यह प्रारंभिक सेटअप ओवरहेड को शामिल किए बिना एक गर्म पुनरावृत्ति रिकॉर्ड करता है।
- प्रोफाइलर लूप के अंदर torch.neuron.synchronize () को कॉल करें। इसके बिना, प्रोफ़ाइलर डिवाइस समाप्त होने से पहले निर्यात कर सकता है और न्यूरोन समय स्तंभ खाली छोड़ सकता है।
- प्रोफाइलिंग के बाद, एक सिस्टम या संयुक्त प्रोफ़ाइल के लिए पूरी आउटपुट निर्देशिका को Neuron Explorer पर अपलोड करें। केवल डिवाइस-प्रोफाइल के लिए, मिलान करने वाली .neff और .ntff फ़ाइलों को व्यक्तिगत रूप से लोड करें। नेफ फाइल में संकलित न्यूरॉन निष्पादन योग्य होता है, और मेल खाने वाले.एनटीएफएफ फ़ाइल में इसके हार्डवेयर इंस्ट्रक्शन ट्रेस होते हैं; फाइलें एक संख्यात्मक हैश साझा करती हैं।
Neuron Explorer सिस्टम ट्रेस, डिवाइस टाइमलाइन और प्रति इंजन ब्रेकडाउन के लिए एक ब्राउज़र-आधारित व्यूअर है। यह Secure Shell सुरंग या Visual Studio Code एक्सटेंशन के माध्यम से पहुँचा जा सकता है। इसका उपयोग संख्यात्मक रूप से क्या key_averages रिपोर्ट करता है इसकी पुष्टि करने और डिस्पैच के बीच की घटनाओं का निरीक्षण करने के लिए करें।
रीडिंग प्रोफाइलर आउटपुट और ट्रेसिंग RMSNorm
विश्लेषण प्रोफाइल RMSNorm, अंकगणित और कटौती संचालन के एक स्पष्ट अनुक्रम के साथ एक छोटा सा ऑपरेशन है। naive PyTorch संस्करण में, प्रत्येक पंक्ति एक या अधिक ATen कार्यों से मेल खाती है और मध्यवर्ती टेंसर का उत्पादन कर सकती है। अनुक्रम गुणा, औसत कमी, एक अतिरिक्त, एक पारस्परिक वर्गमूल और एक अन्य गुणन का उपयोग करता है।
key_averages में), self_privateuse1_time_total द्वारा सॉर्टिंग सबसे अधिक डिवाइस लागत वाले ऑपरेशनों को पहले स्थान देती है। तालिका उन एटीएन संचालन की रिपोर्ट करती है जो चलाए गए थे, उनकी कॉल गिनती और उनके CPU और न्यूरॉन डिवाइस समय पर ध्यान केंद्रित करते हैं। प्रदर्शित अंश आरएमएस नॉर्म ऑपरेशंस पर केंद्रित है जो न्यूरोन डिवाइस समय की रिपोर्ट करते हैं, जबकि पूर्ण आउटपुट में सीपीयू-साइड इवेंट्स जैसे आवंटन और होस्ट-टू-डिवाइस ट्रांसफर भी शामिल हैं।
सरल कार्यान्वयन के लिए, तीन aten::mul कॉल न्यूरॉन डिवाइस समय का सबसे बड़ा हिस्सा हैं, और aten:: mul में उच्चतम कुल उपकरण समय है क्योंकि फ़ंक्शन तीन गुणा करता है। तालिका रिपोर्ट करती हैः Self NEURON कुलः 2.355 एमएस प्रत्येक पंक्ति फलन को मैप करती हैः aten::Mul x * x, x * rms के लिए चलता है, और वजन से अंतिम गुणन; aten::mean आखिरी आयाम कम कर देता है; atenadd:: epsilon मान जोड़ता है और होस्ट-टू-डिवाइस प्रतिलिपि को ट्रिगर करता है क्योंकि स्केलर पर शुरू होता है CPU; atenrsqrt: पारस्परिक वर्गमूल की गणना करता है
एक्सप्लोरर एक ही aten::mul ऑपरेशन को फ्रेमवर्क डिस्पैच से लेकर रनटाइम शेड्यूलिंग तक और हार्डवेयर निष्पादन के लिए न्यूरोनकोर पर ट्रैक कर सकता है। व्यूअर में, समय क्षैतिज रूप से चलता है, जबकि ईवेंट लाइफसाइकिल लंबवत रूप से चलती है। Each ATen ऑपरेशन का समान पैटर्न हैः फ़्रेमवर्क लेन में निर्माण, एनआरटीए_ईक्ज़ेक्यूट_शेड्यूल के रूप में रन टाइम लेन में अनुसूचीकरण, और nc_exec_running के रूप मे हार्डवेयर लेन में डिवाइस निष्पादन. सिस्टम ट्रेस दृश्य घटनाओं को लेनों में व्यवस्थित करता है। डिफ़ॉल्ट समूह मोड में, लेबल उदाहरण / पीआईडी/उप-प्रणाली/पहचानकर्ता पैटर्न का पालन करते हैं। उत्सुक स्थिति में, संचालन अलग से चलाते हैं। निर्भरता श्रृंखला दर्शक एटनः मल्टीसेन्सर को ढांचे की परत के माध्यम से अनुसरण कर सकते हैंः रनिंग टाइम शेड्युलिंग उपकरण निष्पादन और हाइलाइट्स जीवन चक्र ।
तीन कार्यान्वयन और वे क्या प्रकट करते हैं
दूसरा प्रोफाइल अलग-अलग ऑपरेशनों को torch.rms_norm के साथ बदल देता है, जिसे न्यूरॉन एक एकल फ्यूज्ड कर्नेल में कम करता है। फ्यूज़्ड RMSNorm Self NEURON कुलः 403.3 μs के साथ key_averages में एक डिवाइस ऑपरेशन के रूप में दिखाई देता है। ट्रेस एक सिंगल फ्रेमवर्क-टू-हार्डवेयर पथ दिखाता है, न कि अलग अंकगणितीय प्रेषण। भोले मार्ग में, प्रत्येक ऑपरेशन डिस्पैच सीमा को अलग से पार करता है और अपने स्वयं के ढांचे से रनटाइम तक हार्डवेयर रूट का पालन करता है । मिश्रित रास्ते में, एक पायथन कॉल पूरी गणना को कवर करती है।
TorchDynamo पहले पायथन बाइटकोड को एक FX ग्राफ के रूप में कैप्चर करता है, फिर AOTAutograd उस ग्राफ को ATen ऑपरेशनों तक कम कर देता है। बैकएंड तब व्यक्तिगत ऑपरेशन डिस्पैच के बजाय पूरे ग्राफ़ को देखता है। यह ऑपरेशंस को फ्यूज करती है, मेमोरी एक्सेस में सुधार करती है और आलेख को एक ही .neff आर्टिफैक्ट, Neuron Executable File Format में संकलित करती है जो एक हार्डवेयर प्रेषण के तौर पर लॉन्च होती है।
संकलित फ़ंक्शन एक टॉर्च-Compiled Region के रूप में दिखाई देता है key_averages(), साथ Self NEURON कुलः 375.5 μs. संकलিত ग्राफ रनटाइम शेड्यूलिंग और हार्डवेयर निष्पादन के माध्यम से एक पथ का अनुसरण करता है। तालिका फिर से एक डिवाइस निष्पादन दिखाती है, लेकिन इसके लिए मार्ग भिन्न होता है। उद्देश्य से निर्मित फ्यूज ऑपरेशन को लागू करने के बजाय, कंपाइलर मूल पायथन फ़ंक्शंस से फ्यूजन प्राप्त करते हैं। इस रन में, 375 μs torch.rms_norm द्वारा रिपोर्ट किए गए 403 μs के करीब है) । ट्रेस में एक डिस्पैच और एक हार्डवेयर ईवेंट शामिल है, जो घटक संचालन के बीच कोई अंतराल नहीं छोड़ता है।
दोनों पथ RMSNorm को एक ही कर्नेल डिस्पैच में बदल देते हैं। इन रनों में, प्रत्येक फ्यूज्ड एप्रोच नाइव पाथ के डिवाइस समय का लगभग छठा हिस्सा उपयोग करता है। फ्यूजन हार्डवेयर निष्पादन के बीच अंतराल को बंद कर देता है और एक्स_स्क्वायर और mean_sq जैसे मध्यवर्ती मूल्यों को अलग-अलग प्रेषण पर भौतिक होने से रोकता है। बड़े मॉडलों के लिए, वर्कफ़्लो key_averages में हॉटस्पॉट ढूंढना है), इसे एक्सप्लोरर में सत्यापित करना है, फिर यह तय करें कि क्या फ्यूज़ ऑपरेशन या टॉर्च.कॉम्पाइल लागत कम कर सकता है। key_ averages) दिखाता है कि कौन से संचालन उपकरण समय की खपत करते हैं, जबकि पूर्ण आउटपुट सीपीयू-साइड सेटअप और स्थानान्तरण प्रकट करता है; एक्सप्लायर संबंधित दृश्य ट्रेस प्रदान करता है और उन अंतरालों को दर्शाता है जो फ्यूज़न को हटाते हैं।
भाग 2 डिवाइस-स्तरीय प्रोफ़ाइल की जांच करेगा। वहां, .neff आर्टिफैक्ट खोला जाता है, TensorEngine, VectorEngine और प्रत्यक्ष मेमोरी एक्सेस ब्रेकडाउन का निरीक्षण किया जाता है और कर्नेल को यह तय करने के लिए छत पर रखा जाता है कि क्या यह कंप्यूट-बाउंड या मेमरी-बंद है। श्रृंखला क्रेडिट Aritra Roy Gosthipaty इसे प्रेरित करने और नामों Pinak Panigrahi, Samir Araujo, Akhil Azhikodan, Esha Lakhotia और अन्य समीक्षकों के रूप में।
आम गलतियाँ
- Forgetting ProfilerActivity.PrivateUse1 या NeuronConfig को experimental_config के रूप में छोड़ना, जो न्यूरॉन डिवाइस गतिविधि और न्यूरोन-विशिष्ट किनेटो सुविधाओं की उपस्थिति से रोक सकता है।
- correlate_device_time=True सेट नहीं करना, जो डिवाइस समय को key_averages से बाहर छोड़ देता है और Self CPU समय बनाम न्यूरॉन डिवाइस समय तुलना कठिन बनाता है।
- प्रोफाइलर लूप के अंदर torch.neuron.synchronize को छोड़ना, जल्दी निर्यात और एक खाली न्यूरन समय स्तंभ का कारण बनता है।
- केवल फ़िल्टर्ड RMSNorm पंक्तियों को पढ़ना और पूर्ण key_averages () आउटपुट में CPU-साइड आवंटन या होस्ट-टू-डिवाइस स्थानान्तरण की अनुपस्थिति।
- अपूर्ण प्रोफ़ाइल निर्देशिका को Neuron Explorer पर अपलोड करना, या केवल डिवाइस-प्रोफाइल के लिए, संख्यात्मक हैश साझा करने वाली मिलान .neff और .ntff फ़ाइलों को अपलोड नहीं करना।
- मान लीजिए कि torch.compile और torch .rms_norm) एक ही कोड पथ उत्पन्न करते हैं। वे समान डिवाइस समय का उत्पादन कर सकते हैं, लेकिन एक अंतर्निहित फ्यूज ऑपरेशन का उपयोग करता है और दूसरा पायथन फ़ंक्शन से संलयन की खोज करता है।
Comments (0)