
एक सिंथेटिक डाटा पाइपलाइन बनाएँ।
यह मार्गदर्शिका बताती है कि computer vision टीमें उत्पादन के अंधे स्थानों, दुर्लभ स्थितियों और गोपनीयता सीमाओं को कवर करने के लिए सिंथेटिक डेटा पाइपलाइन कैसे बनाती हैं। इसमें संदर्भ मीडिया, शीघ्र पीढ़ी, कंट्रोलनेट, LoRA और स्वचालित जांच शामिल हैं, इस बात पर जोर देते हुए कि उत्पन्न डेटा वास्तविक संग्रह का समर्थन करना चाहिए बजाय प्रतिस्थापित करें।
मुख्य जानकारी
- एक सिंथेटिक डेटा पाइपलाइन सबसे मूल्यवान है जब कंप्यूटर विजन मॉडल कैप्चर किए गए प्रशिक्षण डेटा पर अच्छा प्रदर्शन करता है लेकिन दुर्लभ, अदृश्य उत्पादन स्थितियों में विफल रहता है।
- टीमें गोपनीयता की बाधाओं को दूर करने के लिए सिंथेटिक डेटा अपनाती हैं, दीर्घकालिक मॉडल सेवा लागतों को कम करती हैं और प्रभावी रूप से ठीक-ट्यूनिंग के लिए आवश्यक समृद्ध, विविध उदाहरण उत्पन्न करती हैं।
- पाइपलाइन वास्तविक संदर्भ मीडिया से शुरू होनी चाहिए और कॉन्फ़िगरेशन-संचालित संकेतों का उपयोग करना चाहिए ताकि उत्पन्न उदाहरण यथार्थवादी ज्यामिति, वातावरण और डिवाइस विशेषताओं को संरक्षित करें।
- एक मजबूत पाइपलाइन में संदर्भ इनपुट, कैप्शन, प्रॉम्प्ट जनरेशन, निर्देशित छवि पीढ़ी और स्वचालित सत्यापन शामिल हैं, जिसमें दोषपूर्ण आउटपुट को अस्वीकार करने के लिए फीडबैक लूप होते हैं।
- संश्लेषित डेटा तब उपयोगी होता है जब यह उत्पादन की स्थितियों का प्रतिनिधित्व करता हो और निष्ठा, तथ्यात्मकता तथा निष्पक्ष प्रशिक्षण उदाहरणों को सुनिश्चित करने के लिए स्वचालित जांच आवश्यक होती है।
मेटा विवरण: जानें कि कैसे टीमें मॉडल प्रशिक्षण के लिए सिंथेटिक डेटा पाइपलाइन बनाने के लिए संदर्भ मीडिया, प्रॉम्प्ट जनरेशन, कंट्रोलनेट, लोरा और स्वचालित जांच का उपयोग करती हैं।
टैगः सिंथेटिक डेटा, मॉडल प्रशिक्षण, कंप्यूटर विजन, फाइन-ट्यूनिंग, डाटा पाइपलाइन
%3E%3Cfilfill%20Fill%20Width='800'%20Height='450'% 20Fil = '23f7bff'/%3E3%3Ccircle%20cx='120'%2cy='25r='55dcff' /%3e%3ccircle='20cx'='260dcfy='160dcfty='35dcyty='200dcf0='880dcf1='250dcf2='640dcf3='550dcf4='60dcf6='30dcf8='10dcf9='100dcf12='180dcf02='150dcf06='80dfh='70dcf82='90dcf32='00dcf03='08dcf42='98dcf33='09dcf44='89dcf48='99dfp='92f64='94f68='97f67='96f6f6=79f7f6
कंप्यूटर विजन टीमों के लिए, एक सिंथेटिक डेटा पाइपलाइन सबसे उपयोगी होती है जब कोई मॉडल पहले से ही उत्पादन अंधे स्थान को उजागर कर चुका होता हैः यह कैप्चर किए गए डेटा पर अच्छी तरह से प्रशिक्षित करता है, ऑफ़लाइन मैट्रिक्स पास करता है और फिर इनपुट पर विफल रहता है जिसे किसी ने एकत्र नहीं किया। यह गाइड बताता है कि कैसे टीमें वास्तविक संदर्भ मीडिया को सत्यापित प्रशिक्षण उदाहरणों में बदल सकती हैं, दुर्लभ स्थितियों को कवर करती हैं, और तय करते हैं कि उत्पन्न डेटा संग्रह का समर्थन करने के बजाय कब प्रतिस्थापित करना चाहिए।
क्यों टीमें एक सिंथेटिक डेटा पाइपलाइन बनाते हैं
सामान्य प्रारंभिक बिंदु एक मॉडल है जो विकास में स्वीकार्य दिखता था लेकिन उत्पादन में टूट गया। अधिक डेटा संग्रह अक्सर पहले मदद करता है, फिर मदद करना बंद कर देता हैः फील्ड कैप्चर में हफ्तों लग सकते हैं, एनोटेशन में अधिक समय लगता है, और असफल होने वाले मामले वास्तविक फुटेज में सबसे कम दिखाई देते हैं।
तीन दबाव टीमों को पीढ़ी की ओर धकेलते हैं। सबसे पहले, गोपनीयता और प्रतिबंधित डेटा सीमा क्या कॉपी किया जा सकता है और यह कहाँ जा सकते हैं। General Data Protection विनियमन के डेटा न्यूनीकरण सिद्धांत एक कारण संवेदनशील मूल व्यापक रूप से प्रसार नहीं करना चाहिए, और सार्वजनिक डेटासेट शायद ही कभी उत्पादन स्थितियों से मेल खाते हैं। उत्पन्न उदाहरण एक टीम को प्रशिक्षण देते हैं बिना मूल को स्थानांतरित किए।
दूसरा, हर कार्य के लिए एक स्वामित्व मॉडल की आवश्यकता नहीं होती है। प्रत्येक फ्रेम को जीपीटी -6 एस्ट्रा जैसे बड़े मालिकाना मॉडल में रूट करना प्रति कॉल लागत पैदा करता है, और उत्पाद के जीवनकाल में जो एक ही काम के लिए छोटे गहरे सीखने वाले मॉडल को ठीक करने की एकमुश्त लागत से अधिक हो सकता है, खासकर लोरा जैसी विधियों के साथ।
तीसरा, फाइन-ट्यूनिंग के लिए समृद्ध उदाहरणों की आवश्यकता होती है। विभिन्न परिस्थितियां जो एक ठीक ट्यून को उपयोगी बनाती हैं वे बिल्कुल वही हैं जिन्हें टीम आसानी से इकट्ठा नहीं कर सकती थी। सिंथेटिक डेटा उस बाधा को हटा देता है। कठिन हिस्सा स्वयं छवि पीढ़ी नहीं है; यह यथार्थवादी, सही तरीकों में विविधतापूर्ण और स्वचालित पाइपलाइन के अंदर जांच किए गए उदाहरण का उत्पादन कर रहा है। इससे संश्लेषित डेटा डेटासेट इंजीनियरिंग समस्या बन जाता है, न कि केवल एक त्वरित समस्या।
सिंथेटिक डेटा का अर्थ है वह डेटा जो कैप्चर किए जाने के बजाय उत्पादित किया गया था: एक मॉडल द्वारा उत्पन्न छवियां या वीडियो फ़्रेम लेकिन अंतिम मॉडल को देखने वाले दृश्य गुणों को ले जा रहा है। एनवीआईडीए की संश्लेषित डेटा पीढ़ी का अवलोकन व्यापक क्षेत्र को कवर करता है। दो विशेषताएं इसे उपयोगी बनाती हैं। टीम वितरण को नियंत्रित करती है, यह तय करते हुए कि कितने उदाहरण कठिन प्रकाश में दिखाई देते हैं, अजीब दृष्टिकोण या अपरिचित पृष्ठभूमि। लेबल भी डेटा के साथ आते हैं क्योंकि सिस्टम पहले से ही जानता है कि प्रत्येक उदाहरण में क्या है और कहां है, इसलिए कोई अलग एनोटेशन पास नहीं है और किसी अस्पष्ट फ्रेम पर कोई एनोटरेटर असहमति नहीं है।
कुंजी शब्द प्रतिनिधि है। मॉडल उन डेटा से सीख सकते हैं जो उत्पादन की स्थितियों का प्रतिनिधित्व करते हैं, भले ही डेटा को भौतिक रूप से कैप्चर नहीं किया गया था, लेकिन इसे मान्य करना होगा। सिंथेटिक डेटा सर्वोत्तम प्रथाओं की एक हालिया समीक्षा तथ्यात्मकता, वफादारी और निष्पक्षता पर जोर देकर इस बात को मजबूत करती है।
संदर्भ मीडिया और पांच-चरण पाइपलाइन
उपयोगी और हानिकारक सिंथेटिक डेटा के बीच सबसे बड़ा अंतर यह है कि क्या पीढ़ी कुछ वास्तविक से शुरू होती है। टेक्स्ट-ओनली जनरेशन प्रशंसनीय दिखने वाली छवियां बना सकती है जो उत्पादन इनपुट की तरह व्यवहार नहीं करती हैंः ज्यामिति सूक्ष्म रूप से गलत, वातावरण सामान्य, और कैप्चर डिवाइस का दृश्य चरित्र गायब है। संदर्भ छवि आधारित और संदर्भ वीडियो-आधारित पीढ़ी इससे बचती है कि टीम पहले से ही असली मीडिया ले रही है, वांछित परिवर्तन का वर्णन कर रहा है, और शेष दृश्य को जब्त किए जाने पर केवल उस पहलू को बदलने देता है। यह उस अंतराल को भी कम करता है जिसे प्रारंभिक डोमेन यादृच्छिकरण अनुसंधान को विशुद्ध रूप से अनुकरणित छवियों के साथ पुल करना था।
प्रोम्प्ट को अंधाधुंध रूप से पुनः उपयोग करने के बजाय संदर्भ से प्राप्त किया जाना चाहिए। संदर्भ सिस्टम को बताता है कि फ्रेम में क्या है; कॉन्फ़िगरेशन इसे कहता है कि क्या बदलना चाहिए। उन्हें अलग रखने से प्रक्रिया विन्यास-संचालित हो जाती है, इसलिए एक नई खोज की गई कमजोरी विकास कार्य के बजाय एक विन्यास परिवर्तन बन जाती है।
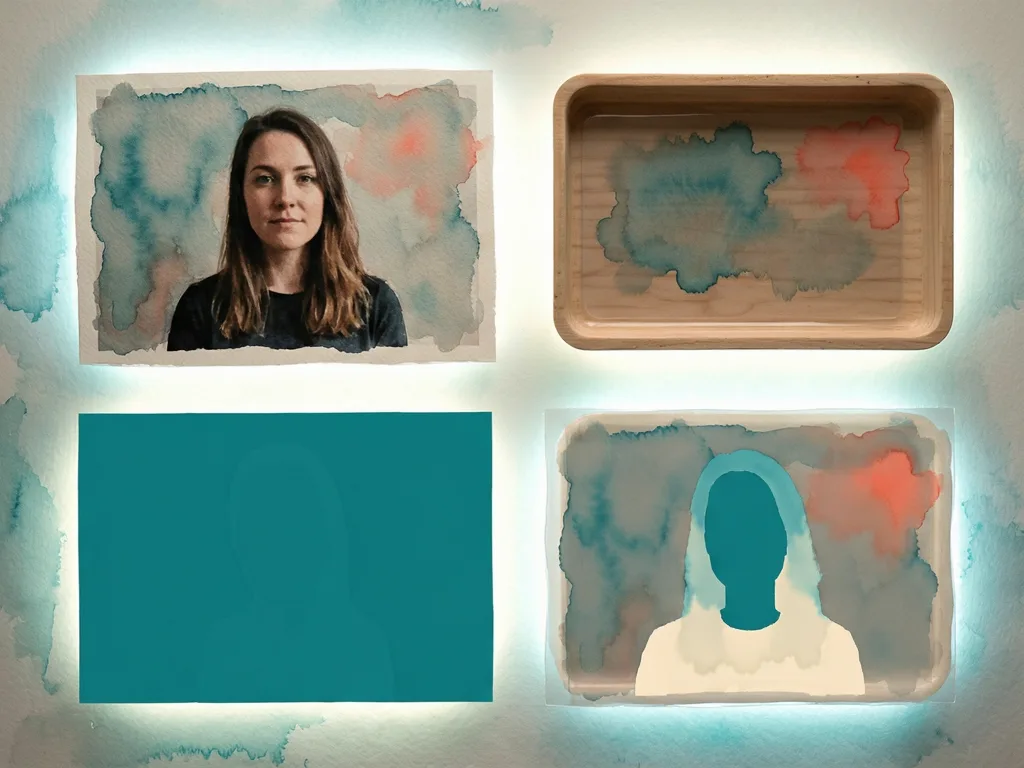
एक कामकाजी पाइपलाइन को पांच चरणों में संगठित किया जा सकता है, जिसमें फीडबैक लूप होता है ताकि विफलताएं जमा होने के बजाय खुद को ठीक कर सकें। प्रत्येक चरण अपने से पहले वाले का कार्य अस्वीकार कर सकता है।
इनपुट वास्तविक संदर्भ मीडिया, छवियां या वीडियो हैं, जो वांछित परिवर्तन और किसी भी संरचनात्मक मार्गदर्शन का वर्णन करने वाले विन्यास के साथ जुड़ा हुआ है। एक कैप्शन चरण तब संदर्भ मीडिया का वर्णन करता है, और प्रॉम्प्ट-जनरेशन कदम उस विवरण को कॉन्फ़िगरेशन के साथ एक दृश्य-जागरूक संपादन निर्देश में जोड़ता है। उत्पादन के दौरान, इंजन निर्देशित संपादित लागू होता है, इसके साथ स्ट्रक्चरल गाइडेंस जैसे किनारों या गहराई के साथ आपूर्ति की जाती है, जैसा कि कंट्रोलनेट में है, इसलिए परिणाम ज्यामितीय रूप से सुसंगत रहते हैं।
स्वचालित सत्यापन वह जगह है जहां पाइपलाइन डेटासेट को ईमानदार रखती है। जनरेटिव मॉडल चुपचाप विफल हो सकते हैंः एक संपादन प्रशंसनीय लग सकता है लेकिन सूक्ष्म रूप से गलत हो सकता है, या मॉडल ऐसी सामग्री का आविष्कार कर सकता है जिसे कभी भी अनुरोध नहीं किया गया था। अप्रमाणित आउटपुट बिना किसी दृश्य त्रुटि के मॉडल की गुणवत्ता को गिरा सकता है। यहां तक कि जांचने वाले मॉडल में ऑब्जेक्ट भ्रम पर शोध दिखाता है, इसलिए प्रत्येक उत्पन्न नमूना, न केवल स्पॉट-चेक किए गए उपसमूह को दो स्वतंत्र मॉडल संचालित चेक पास करना चाहिए।
अप्रत्याशित सामग्री का पता लगाना उन वस्तुओं या विवरणों की तलाश करता है जो स्रोत सामग्री में नहीं थे और न ही अनुरोध किए गए थे, बनावटी सामग्री को चिह्नित करते हैं। विशेषता और गुणवत्ता सत्यापन पुष्टि करता है कि लक्षित विशेषता सही ढंग से लागू की गई थी और इसके बाहर सब कुछ अपरिवर्तित रहा। एक नमूना दोनों जांच पास करना चाहिए। यदि यह विफल रहता है, तो इसे केवल फेंक दिया जाता हैः यह अपनी विफलता के कारण संलग्न करने के साथ वापस रूट करता है, एक समायोजित निर्देश उत्पन्न होता है, और यह स्वचालित रूप से फिर से सत्यापित किया जाता है। प्रत्येक निर्णय के बगल में एक विश्वास स्कोर सीमा मामलों को स्पष्ट असफलताओं से अलग करने में मदद करता है।
अंत में, पास किए गए नमूनों को स्वचालित लेबल के साथ प्रशिक्षण-तैयार डेटासेट में इकट्ठा किया जाता है। असफल नमूने सुधार के लिए वापस रूट होते हैं। प्रत्येक नमूना एक पूर्ण इतिहास रखता हैः मूल संदर्भ मीडिया, प्रत्येक पुनर्जनन प्रयास और इसका अंतिम सत्यापित रूप। एक विवरण जितना लगता है उससे अधिक मायने रखता है। वास्तविक फोटो को सीधे संपादित करना प्रामाणिक दृश्य चरित्र को चिकना कर सकता है जो प्रशिक्षण डेटा को यथार्थवादी बनाता है, इसलिए संपादन स्वच्छता से उत्पन्न होता है और मूल पर वापस मिश्रित होता है।
प्रशिक्षण अंतराल, गुणवत्ता जांच और वास्तविक डेटा एंकर
ऑब्जेक्ट डिटेक्शन और इसी तरह के कार्यों के लिए, सिंथेटिक डेटा का सबसे विश्वसनीय उपयोग सामान्य के बजाय लक्षित होता है। लक्ष्य उन स्थितियों की गिनती को बढ़ाना है जो डेटासेट में मुश्किल से कवर होते हैं। कंप्यूटर विजन में सिंथेटिक्स डाटा एगमेंटेशन का एक सर्वेक्षण तकनीकों के व्यापक सेट को मैप करता है, लेकिन जिन परिस्थितियों में आमतौर पर मदद की आवश्यकता होती है वे असामान्य वातावरण हैं जिन्हें मूल कैप्चर अभियान कभी नहीं देखा गया था; कठिन प्रकाश व्यवस्था, जिसमें मजबूत बैकलाइटिंग और रात के दृश्य शामिल हैं; उपलब्ध विवरण को कम करने वाले उपकरणों या दूरी से निम्न-गुणवत्ता वाली छवियां; असामान्य दृष्टिकोण और खड़ी कोण; वस्तुएं जो केवल आंशिक रूप से दिखाई देती हैं; अपरिचित पृष्ठभूमि, इसलिए मॉडल चुनौतीपूर्ण बैकग्राउंड के रूप में पृष्ठभूमि का उपयोग करना बंद कर देता है; पहना हुआ, क्षतिग्रस्त या चिंतनशील सतहों सहित वस्तु उपस्थिति; और दुर्लभ परिदृश्य जो वास्तविक फुटेज महीनों में केवल कुछ ही बार दिखाई देते हैं।
एक बार पाइपलाइन मौजूद होने के बाद, फाइन-ट्यूनिंग अधिक यांत्रिक हो जाता है। कमजोर परिस्थितियों की ओर भारित सिंथेटिक उदाहरणों के साथ वास्तविक डेटा को मिलाएं, ठीक करें, फिर स्थिति द्वारा विभाजित वास्तविक होल्डआउट पर मूल्यांकन करें। किसी शर्त को ओवरवेटिंग करने से कहीं और प्रदर्शन में कमी आ सकती है। यदि सिंथेटीक उदाहरण दृश्य हस्ताक्षर साझा करते हैं, तो एक मॉडल उस हस्ताक्षर को सीखने के बजाय सीख सकता है।
वॉल्यूम उत्पादन करने के लिए सबसे आसान चीज है और कम से कम मूल्यवान है। एक सुसंगत संरचनात्मक त्रुटि ले जाने वाली दस हजार छवियां मॉडल को उस त्रुटि की उम्मीद करना सिखाती हैं, जबकि कुछ सौ मान्य उदाहरण जो वास्तविक अंतराल को कवर करते हैं वे मीट्रिक को स्थानांतरित कर सकते हैं। प्रत्येक नमूना दृश्य यथार्थवाद, सही ऑब्जेक्ट संरचना, प्रकाश व्यवस्था, छायाओं और संदर्भ दृश्य के साथ परिप्रेक्ष्य की स्थिरता, संदर्भ में आधारित यथार्थवादी वातावरण, मॉडल कुंजियों पर विशेषताओं का संरक्षण, कोई निर्मित सामग्री नहीं, और वास्तविक नमूनों के खिलाफ तुलना इसलिए उत्पन्न नमूने असली लोगों के बगल में बाहर खड़े नहीं होते हैं।
मानव समीक्षा एक छोटी, अधिक जानबूझकर भूमिका रखती है। वास्तविक उदाहरणों के खिलाफ प्रत्येक बैच के हिस्से की समीक्षा करना व्यवस्थित समस्याओं को पकड़ता है जिन्हें स्वचालित जांच कभी भी खोजने के लिए कॉन्फ़िगर नहीं किया गया था, पेशेवर AI डेटा सेवाओं में उपयोग किए जाने वाले गुणवत्ता-नियंत्रित समीक्षा की तरह।
इकोनॉमिक्स मैनुअल कलेक्शन से भी भिन्न होता है। संग्रह फील्ड टाइम, इन्फ्रास्ट्रक्चर, उपकरण, यात्रा, स्टोरेज, एनोटेशन, गवर्नेंस और क्वालिटी रिव्यू पर खर्च करता है, इसमें से अधिकांश मानव घंटों के साथ स्केलिंग करते हैं। कई टीमें समर्पित डेटा एनोटैशन सेवाओं का भी उपयोग करती हैं, जो आंतरिक बोझ को कम कर सकती हैं लेकिन फिर भी मानव समय पर भरोसा करती हैं। जनरेशन क्लाउड कंप्यूटिंग पर चलती है और समानांतर प्रसंस्करण के माध्यम से पैमाने पर होती है, इसलिए लागत हेडकाउंट के बजाय गणना मिनट ट्रैक करती है। व्यवहार में, इस आकार की एक पाइपलाइन प्रति घंटे सैकड़ों सत्यापित नमूनों का उत्पादन कर सकती है, जिसमें बैच के लिए दसियों डॉलर की गणना लागत होती है जिसे अन्यथा एकत्र करने और लेबल करने में दिन लगेंगे। संग्रह के तहत, एक नई आवश्यकता का मतलब एक नया अभियान है। पीढ़ी के तहत इसका अर्थ है एक नया कॉन्फ़िगरेशन और एक रन।
गोपनीयता में सुधार होता है, लेकिन यह गायब नहीं हो जाता। सिंथेटिक डेटा को सीमित करता है कि शासन संबंधी चिंताओं को दूर किए बिना कितनी संवेदनशील सामग्री का प्रसार होना चाहिए। संदर्भ मीडिया अभी भी वास्तविक डेटा है जो किसी भी नियमों के तहत लागू होते हैं। जनरेटिव मॉडल अपने प्रशिक्षण डेटा के तत्वों को पुनः उत्पन्न कर सकते हैं, और कुछ संदर्भों से निर्मित एक डेटासेट लेबल की तुलना में अधिक पहचान जानकारी रख सकता है।
सबसे सुरक्षित पैटर्न सिंथेटिक डेटा को कवरेज और नियंत्रण के रूप में व्यवहार करना है, संग्रह के लिए प्रतिस्थापन नहीं। पीढ़ी केवल यह जानती है कि टीम उसे क्या बताती है, जबकि वास्तविक डेटा वितरण को एंकर करता है और मूल्यांकन के लिए एकमात्र विश्वसनीय आधार बना रहता है। एक उचित वर्कफ़्लो पहले वास्तविक डेटा पर प्रशिक्षित करना और एक भरोसेमंद बेसलाइन स्थापित करना, संचयी की बजाय स्थिति द्वारा त्रुटियों का विश्लेषण करना, कम प्रतिनिधित्व वाली स्थितियों के लिए कृत्रिम उदाहरण उत्पन्न करना, संयोजन पर ठीक-ठाक ट्यून करते हुए पर्याप्त वास्तविक डेटा रखना ताकि वितरण स्थिर हो सके, शर्त से टूटने वाले वास्तविक होल्डआउट पर मूल्यांकन करें, फिर जो कुछ भी कमजोर है उसके उद्देश्य से पीढ़ी के अगले दौर के साथ दोहराएं।
लूप किसी भी निश्चित अनुपात से अधिक मायने रखता है। जो कोई एक सार्वभौमिक सिंथेटिक-से-वास्तविक अनुपात का हवाला दे रहा है वह अनुमान लगा रहा है, क्योंकि सही मिश्रण कार्य पर निर्भर करता है, अंतर और उदाहरण उत्पादन के कितने करीब हैं। उस मिश्रण को निपटाना अक्सर AI परामर्श सगाई में एक प्रारंभिक प्रश्न होता है। उन टीमों के लिए जिनके मॉडल दुर्लभ लेकिन महत्वपूर्ण इनपुट पर विफल रहते हैं, अगला कदम केवल अधिक डेटा नहीं है। यह एक पाइपलाइन है जो प्रशिक्षण को वास्तव में उत्पादन की तरह दिखने के साथ संरेखित रखने के लिए पर्याप्त रूप से तेजी से उत्पन्न, सत्यापित और सही उदाहरण बना सकती है।
Comments (0)