
पुनरावर्ती स्व-सुधार करने में सक्षम foundation model प्रणालियों की ओर प्रगति कर रहा है।
Recursa AI मॉडलों को कार्य उत्पन्न करने, अभ्यास और आत्म-व्युत्पन्न कौशल संग्रहीत करके नए क्षेत्रों को सीखने में मदद करता है, Harvey LAB पास दरों में सुधार।
मुख्य जानकारी
- रिसोर्स फाउंडेशन मॉडलों को मानव विशेषज्ञों या मजबूत शिक्षक मॉडल की आवश्यकता के बिना अपने स्वयं के अनुभव से नए डोमेन सीखने में सक्षम बनाता है।
- यह दो चरणों का उपयोग करता है: ज्ञान अंतराल को संबोधित करने के लिए एक ज्ञान रिपॉजिटरी बूटस्ट्रैपिंग, और व्यवहार अंतर को दूर करने के लिये पुनरावर्ती आत्म-सुधार।
- Harvey LAB 89s Firm Knowledge बेंचमार्क पर, Recursa DeepSeek -V4.1-फ्लैश के साथ सभी पास दरों को 30.0% से बढ़ाकर 55.0% और Qwen3.8-Flash के साथ 35.0% से 46.0% कर देता है।
- यह विधि सबसे अधिक प्रासंगिक है जब विशेषज्ञ डेटा, पर्यवेक्षण या शिक्षक मॉडल सीमित होते हैं, हालांकि परिणाम सार्वभौमिक गारंटी नहीं हैं।
मेटा विवरण: रेकर्सा स्वयं-व्युत्पन्न कौशल को संग्रहीत करके और Harvey LAB Firm Knowledge ऑल पास दरों को बढ़ाकर 55.0% तथा 46.0% तक नए डोमेन सीखने में फाउंडेशन मॉडल की मदद करता है।
टैगः संसाधन, नींव मॉडल, हार्वे लैब, DeepSeek -V4.1-फ्लैश, Qwen3.8-फ़्लैश
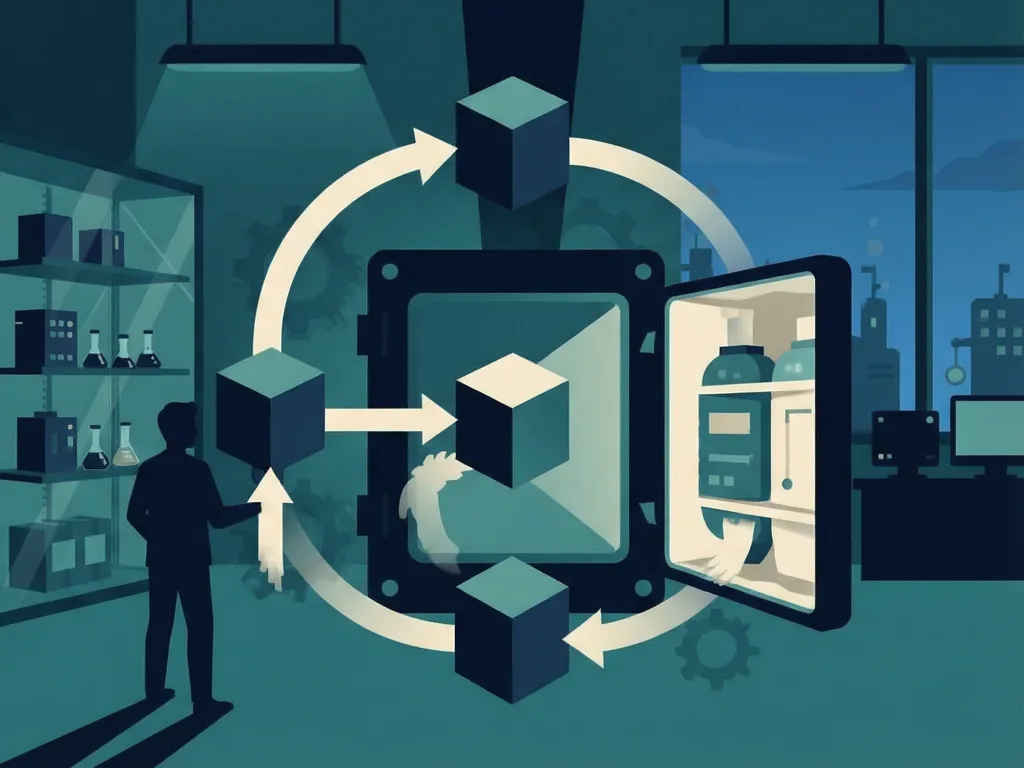
चित्रित छवि: ज्ञान भंडार को खिलाने वाले एक स्व-शिक्षण लूप का अमूर्त मैत्रीपूर्ण उदाहरण, कोई वास्तविक लोग नहीं, कोई लोगो नहीं, न ही पाठ।
foundation model, एक व्यापक रूप से प्रशिक्षित AI मॉडल को अनुकूलित करने वाली टीमों के लिए, कम विशेषज्ञ-लिखित डेटा या विश्वसनीय पर्यवेक्षण वाले नए क्षेत्र में, Recursa अपने स्वयं के अनुभव से सीखने का एक तरीका प्रदान करता है। arXiv पेपर 2611.04035 में वर्णित विधि के लिए मानव विशेषज्ञों या मजबूत शिक्षक मॉडल की आवश्यकता नहीं होती है। इसके बजाय, सिस्टम डोमेन सामग्रियों से कार्य उत्पन्न करता है, उन पर अभ्यास करता है और जो सीखता है उसे संग्रहीत करता है.
सिस्टम कैसे सीखता है
Recursa एक ज्ञान भंडार रखता है जिसमें डोमेन-विशिष्ट कौशल, उनका उपयोग कब करने के निर्देश, पिछले कार्यों की यादें और सुधार पर प्रतिबिंब होते हैं।
पहला चरण बूटस्ट्रैपिंग है: सिस्टम डोमेन सामग्रियों और कार्यों पर प्रथाओं से रिपॉजिटरी बनाता है। यह ज्ञान अंतराल को संबोधित करता है, जिसका अर्थ है कि मॉडल में नए डोमेन के लिए सही तथ्य या प्रक्रियाएं नहीं हैं।
दूसरा चरण पुनरावर्ती आत्म-सुधार हैः समानांतर शिक्षार्थी कार्य चलाते हैं और स्थानीय सुधारों का प्रस्ताव करते हैं। उन प्रस्तावों को मान्य किया जाता है और रिपॉजिटरी में वापस विलय कर दिया जाता है। यह व्यवहार अंतर को लक्षित करता है, जहां मॉडल उपयोगी सामग्री जानता हो सकता है लेकिन इसका लगातार उपयोग नहीं करता है। सिस्टम का अपना मॉडल प्रक्रिया को संचालित करता है जिसमें यह सीखता है कि कैसे इसे बेहतर बनाया जाए।
बेंचमार्क परिणाम
Harvey LAB के Firm Knowledge बेंचमार्क पर, Recursa DeepSeek -V4.1-फ्लैश के साथ आयोजित परीक्षण कार्यों पर सभी पास दर को 30.0% से बढ़ाकर 55.0% कर देता है। यह Qwen3.8-Flash के साथ 35.0% से 46.0% तक ऑल-पास रेट भी बढ़ाता है।
होल्ड-आउट टेस्ट टास्क मूल्यांकन कार्य हैं जिनका प्रशिक्षण के दौरान उपयोग नहीं किया जाता है, इसलिए रिपोर्ट किए गए लाभ उस बेंचमार्क सेटिंग के भीतर अनदेखे मामलों पर प्रदर्शन दिखाते हैं।
यह क्यों मायने रखता है
यह दृष्टिकोण तब प्रासंगिक होता है जब विशेषज्ञ डेटा, पर्यवेक्षण या शिक्षक मॉडल दुर्लभ होते हैं। यह अधिक स्वायत्त डोमेन अनुकूलन की ओर एक मार्ग का सुझाव देता है, लेकिन साक्ष्य कागज में नामित बेंचमार्क और मॉडलों तक सीमित है। पाठकों को परिणामों को ठोस प्रदर्शन के रूप में देखना चाहिए, न कि सार्वभौमिक गारंटी।
Comments (0)