
क्या TypeSafe द्वारा Jev AI एजेंटों को एक और LLM पर भरोसा किए बिना सुरक्षित बना सकता है?
एक निर्णय-पहला मॉडल कार्रवाई से पहले AI एजेंट टूल कॉल की समीक्षा कर सकता है, बिना किसी अन्य LLM की लागत, विलंबता या अनिश्चितता के जोखिम को कम करता है।
मुख्य जानकारी
- लेख टाइपसेफ के जेव को एक निर्णय-प्रथम मॉडल के रूप में चर्चा करता है जो वास्तविक दुनिया की कार्रवाइयों से पहले एआई-एजेंट टूल कॉल का मूल्यांकन कर सकता है, जिसका उद्देश्य किसी अन्य को जोड़ने के बिना सुरक्षा में सुधार करना है LLM।
- इसमें इस बात पर प्रकाश डाला गया है कि ई-मेल भेजना, डेटा हटाना, कमांड चलाना या सेटिंग्स बदलना जैसी जोखिम भरी कार्रवाइयों को कार्रवाई से पहले जांच की आवश्यकता होती है क्योंकि प्रशंसनीय एजेंट योजनाएं अभी भी तत्काल हानिकारक दुष्प्रभाव पैदा कर सकती हैं।
- एक निर्णय-पहला मॉडल संरचित टूल-कॉल विवरण का निरीक्षण करके और मानव को अनुमति, ब्लॉक, पुष्टि या वृद्धि जैसे सरल परिणाम लौटाकर गेटकीपर के रूप में कार्य करेगा।
- शीर्षक को सिद्ध साक्ष्य के बजाय एक आशाजनक डिजाइन विचार के रूप में प्रस्तुत किया गया है, क्योंकि लेख में जेव्स मॉडल प्रकार, बेंचमार्क, झूठी सकारात्मक/झूठे नकारात्मक दरों, मूल्य निर्धारण या विरोधी परीक्षण पर विवरण का अभाव है।
मेटा विवरण: जानें कि कैसे टाइपसेफ के जेव जैसे निर्णय-प्रथम मॉडल वास्तविक दुनिया की कार्रवाइयों से पहले जोखिम भरे AI एजेंट टूल कॉल को पकड़ सकता है, बिना किसी अन्य LLM को जोड़े।
टैगः निर्णय-पहला मॉडल, AI एजेंटों, उपकरण कॉल, TypeSafe Jev, एजेंट सुरक्षा
विशेष रुप से प्रदर्शित छवि: एक छोटी सी ढाल की अमूर्त मैत्रीपूर्ण चित्रण AI एजेंट, कोई वास्तविक लोग, कोई लोगो, कोई पाठ से आउटगोइंग API कॉल की जांच कर रहा है।
यह उन पाठकों के लिए है जो यह समझना चाहते हैं कि email , फ़ाइलों, डेटाबेस, कोड या बाहरी सेवाओं को छूने से पहले AI एजेंटों की जांच कैसे की जा सकती है। टाइपसेफ का जेव एक निर्णय-प्रथम मॉडल के विचार से जुड़ा हुआ है जो वास्तविक दुनिया में कार्रवाई होने से पहले जोखिम भरे टूल कॉल पकड़ सकता है। स्रोत सामग्री प्रकाशन तिथि, बेंचमार्क स्कोर, मूल्य निर्धारण या रिलीज़ विवरण प्रदान नहीं करती है, इसलिए नीचे दी गई चर्चा शीर्षक को सिद्ध उत्पाद परिणाम के बजाय डिजाइन प्रश्न के रूप में मानती है।
डाकघर मेज पर क्या रखता है
हेडलाइन एक व्यावहारिक समस्या की ओर इशारा करती हैः एक AI एजेंट संभावित अगला कदम उत्पन्न कर सकता है, लेकिन विश्वसनीयता सुरक्षा नहीं है। यदि एजेंट संदेश भेजने, डेटा हटाने, कमांड चलाने या सेटिंग बदलने का प्रस्ताव करता है, तो सवाल यह है कि क्या प्रस्तावित कार्रवाई को अनुमति दी जानी चाहिए, अवरुद्ध, संशोधित किया जाना चाहिए या मानव में बढ़ाया जाना चाहिए। निर्णय-पहला मॉडल, जैसा कि वाक्यांश से पता चलता है, इसके बाद के बजाय कार्रवाई से पहले तैनात है। केवल उपयोगकर्ता अनुरोध का जवाब देने के बजाय, यह उस निर्णय का मूल्यांकन करता है जो वास्तविक दुनिया प्रभाव को ट्रिगर करेगा।
"without another LLM" का संदर्भ भी महत्वपूर्ण है। LLM, या large language model , वह तकनीक है जिसका उपयोग अधिकांश एजेंट भाषा और योजना को समझने के लिए करते हैं। कई सुरक्षा प्रणालियाँ एक को दूसरे के साथ लपेटने की कोशिश करती हैं जो योजना की समीक्षा करता है। यह काम कर सकता है, लेकिन यह लागत, विलंबता और एक अन्य मॉडल जोड़ता है जो स्वयं अविश्वसनीय हो सकता है। टाइपसेफ का जेव शीर्षक में एक वैकल्पिक पथ के रूप में प्रस्तुत किया गया हैः एक ऐसा मॉडल जो यह तय करने पर केंद्रित है कि क्या टूल कॉल सुरक्षित है, न कि वार्तालाप प्रतिक्रिया उत्पन्न करना।
क्यों जोखिम भरा उपकरण कॉल एक अलग जांच के लायक
एक टूल कॉल चैट विंडो के बाहर कुछ करने के लिए मॉडल से एक अनुरोध है। एजेंट सिस्टम में, मॉडल किसी फ़ाइल को पढ़ने, लिखने, कॉल API, कोड निष्पादित करने, email भेजने, वेब पेज खोलने या डेटाबेस को संशोधित करने का अनुरोध कर सकता है। इनमें से कुछ क्रियाएं रिवर्सिबल हैं, जैसे लॉग फाइल पढ़ना। अन्य नहीं हैं, जैसा कि रिकॉर्ड हटाना, सामग्री प्रकाशित करना, पैसे स्थानांतरित करना, या सुरक्षा सेटिंग्स बदलना। खतरा न केवल यह है कि मॉडल गलत हो सकता है, बल्कि गलत आउटपुट के तत्काल दुष्प्रभाव हो सकते हैं।
इसीलिए एक सुरक्षा परत को प्रस्तावित कार्रवाई का निरीक्षण करने की आवश्यकता होती है, न कि उपयोगकर्ता प्रॉम्प्ट JUST । एक उपयोगकर्ता किसी एजेंट से इनबॉक्स को साफ करने के लिए कह सकता है, और एक सक्षम एजेंट इसे हजारों संदेशों को हटाने के रूप में व्याख्या कर सकता है। अनुरोध सामान्य है, लेकिन प्रस्तावित टूल कॉल उच्च-प्रभाव वाला होता है। एक अलग जांच नीति के साथ इच्छित कार्रवाई की तुलना कर सकती हैः जो इसे अनुमोदित कर सकते हैं, कौन सी प्रणालियां दायरे में हैं, क्या लक्ष्य संवेदनशील है, चाहे ऑपरेशन बैच या एकल हो, और क्या ड्राई रन संभव है। जितना अधिक एक्शन वास्तविक डेटा या बाहरी सेवाओं को छूता है, उतना ही पूर्व-एक्शन समीक्षा मायने रखती है।
एक निर्णय-पहला मॉडल दूसरे से कैसे भिन्न होता है LLM
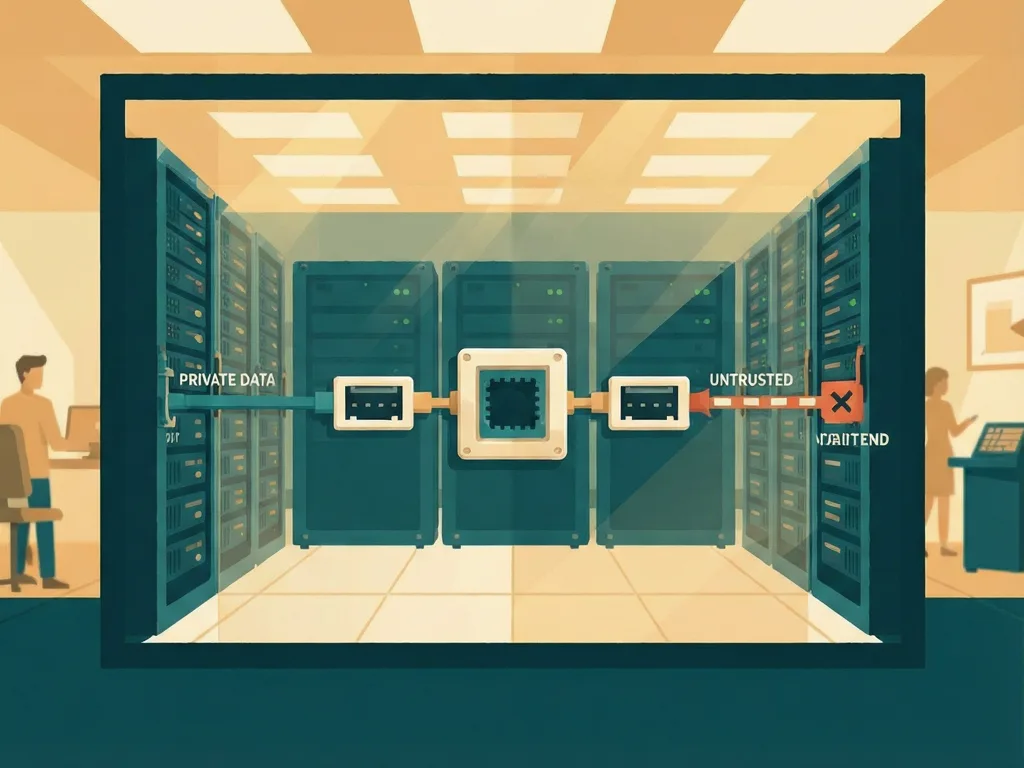
If Jev वास्तव में निर्णय-पहला है, डिजाइन संभवतः मॉडल को एक सामान्य सहायक के बजाय गेटकीपर के रूप में मानता है। एक सामान्य LLM एक ही चरण में एक उपयोगी उत्तर और टूल कॉल का उत्पादन कर सकता है। गेटकीपर्स प्रस्तावित उपकरण कॉल या इसके पीछे संरचित निर्णय प्राप्त करता है, और एक सरल परिणाम देता हैः अनुमति दें, ब्लॉक करें, पुष्टि के लिए पूछें, या मानव समीक्षा की आवश्यकता होती है। उस पैटर्न में, मॉडल का काम नई योजना नहीं लिखना है बल्कि पहले से बनाई गई योजना का न्याय करना है।
एक उपकरण कॉल में फ़ील्ड हैंः नाम, तर्क, लक्ष्य, अनुमति दायरा, अपेक्षित साइड इफेक्ट्स और तात्कालिकता। उन क्षेत्रों को देखने के लिए निर्णय-पहले मॉडल को प्रशिक्षित या कॉन्फ़िगर किया जा सकता है। यह असंगतताओं को पकड़ सकता है जो चैट-शैली समीक्षक याद कर सकते हैं, जैसे कि email अप्रत्याशित प्राप्तकर्ता को भेजें, बैकअप के बिना हटाएं ऑपरेशन, या अनुमत निर्देशिका से अधिक कमांड। आउटपुट संकीर्ण होने के कारण इसकी तर्कों की व्याख्या करने के लिए बड़े LLM से पूछने की तुलना में भी तेज़ हो सकती है।
एक संकीर्ण मॉडल नाजुक हो सकता है. यह अक्सर हानिरहित कार्यों को अवरुद्ध कर सकता है, या जब अनुरोध असामान्य तरीके से वाक्यांशित किया जाता है तो यह हानिकारक कार्यों की अनुमति दे सकता है। नीति जांच केवल उतनी ही अच्छी होती है जितनी कि नीति, वह जो डेटा देखती है और एजेंट को इसे दरकिनार करने से रोकने की क्षमता। यदि एजेंट गेटकीपर के माध्यम से जाने के बिना कोड निष्पादित कर सकते हैं, तो द्वारपाल वैकल्पिक बन जाता है।
दावा क्या साबित नहीं करता है
हेडलाइन उपयोगी है, लेकिन यह एक सावधान पाठक को आवश्यक सबूत प्रदान नहीं करता है। यह नहीं कहता कि टाइपसेफ का जेव किस तरह का मॉडल है, चाहे वह सार्वजनिक, वाणिज्यिक, open-source , या आंतरिक हो। यह सटीकता, झूठी-सकारात्मक दर, झूठे नकारात्मक दर, विलंबता या लागत की रिपोर्ट नहीं करती है। इसमें यह नहीं कहा गया है कि क्या मॉडल विरोधी संकेतों, वास्तविक एजेंट के निशान या सिंथेटिक उदाहरणों के खिलाफ परीक्षण किया गया था। यह यह भी नहीं बताता है कि जेव मल्टी-स्टेप योजनाओं को कैसे संभालती है, जहां एक कदम हानिरहित लगता है लेकिन अगला कदम खतरनाक बन जाता है।
उन विवरणों के बिना, सबसे सुरक्षित निष्कर्ष यह है कि निर्णय-पहले की जांच एक आशाजनक वास्तुकला है, पूर्ण प्रमाण नहीं। एक पाठक को तीन दावों को अलग करना चाहिएः यह विचार कि पूर्व कार्रवाई जाँच मदद करते हैं, दावा है कि जेव इस तरह के चेक लागू करता है, और दावे है कि Jev किसी अन्य LLM आधारित गार्डरेल से बेहतर प्रदर्शन करता है। पहला सुरक्षा और स्वचालन में व्यापक रूप से सच है। दूसरा उत्पाद प्रलेखन की आवश्यकता है। तीसरे को बेंचमार्क और स्पष्ट परीक्षण सेटअप की आवश्यकता होती है।
यदि आप एजेंटों का उपयोग या निर्माण करते हैं तो आगे क्या देखना है
केवल एजेंटों का उपयोग करने वाले पाठकों के लिए, व्यावहारिक टेकअवे यह पूछना है कि क्रियाएं कहां रुकती हैं। एक सुरक्षित एजेंट को निष्पादित होने से पहले इच्छित टूल कॉल दिखाना चाहिए, विशेष रूप से भेजने, हटाने, खरीदने, पोस्ट करने या पहुंच को संशोधित करने के लिए। यदि इंटरफ़ेस उस चरण को छिपाता है, तो उपयोगकर्ता का नियंत्रण कम होता है। अगर एजेंट पुष्टि का अनुरोध कर सकता है, उपयोगकर्ता को इस पुष्टिकरण को वास्तविक अनुमोदन जांच बिंदु के रूप में इलाज करना चाहिए, न कि सजावटी चेतावनी।
बिल्डरों के लिए, अधिक दिलचस्प सवाल यह है कि क्या जेव को एक अनिवार्य मिडलवेयर परत के रूप में एकीकृत किया जा सकता है। अगला उपयोगी कदम दस्तावेज होगा जो दिखाता है कि निर्णय-पहले मॉडल को सामान्य उपकरण APIs से कैसे कनेक्ट करें, नीतियों को कॉन्फ़िगर करें, अवरुद्ध कॉल लॉग कैसे करें और अपवादों को कैसे संभालें। एक मजबूत कार्यान्वयन में कम से कम विशेषाधिकार एक्सेस, जोखिम भरे संचालन के लिए सैंडबॉक्स निष्पादन और अपरिवर्तनीय कार्यों के लिए मानव वृद्धि पथ भी शामिल होंगे। शीर्षक एक दिशा का सुझाव देता है जिसे देखने लायक हैः सुरक्षा मॉडलों को सही बात कहने के बारे में कम हो सकती है और सिस्टम को गलत कार्रवाई से इनकार करने के लिए अधिक हो सकती हैं।
Comments (0)