
AI एजेंटों के लिए मेमोरी स्टैक में बिल्डिंग ब्लॉक्स, पैटर्न और फ्रेमवर्क होते हैं।
AI एजेंट मेमोरी कार्यशील, एपिसोडिक और सिमेंटिक प्रकारों, पुनर्प्राप्ति पैटर्न और फ्रेमवर्क डिज़ाइन का उपयोग करके विंडो के बाहर संदर्भ को संग्रहीत करती है।
मुख्य जानकारी
- AI एजेंटों को बाह्य स्मृति की आवश्यकता होती है क्योंकि LLM संदर्भ कॉल के बीच खो जाता है; मेमोरी को कार्यों और सत्रों में जानकारी संग्रहीत, पुनर्प्राप्त और अद्यतन करनी चाहिए।
- कार्यशील, एपिसोडिक और सिमेंटिक मेमोरी अलग-अलग भूमिकाएं निभाती हैंः वर्तमान संदर्भ, अतीत की घटनाओं और परिणामों और टिकाऊ तथ्यों या प्राथमिकताओं।
- विश्वसनीय मेमोरी डिज़ाइन महत्व को स्कोर करता है, एजेंट भूमिका द्वारा स्मृति का दायरा रखता है, निर्णय बिंदुओं पर पुनर्प्राप्त करता है और पुरानी या मिश्रित जानकारी से बचने के लिए प्रस्थान ट्रैक करता है।
- फ्रेमवर्क विकल्प मायने रखते हैंः सरल स्टोर्स छोटे कार्यों के लिए पर्याप्त हो सकते हैं, जबकि संरचित मेमोरी, साझा-मेमोरी नियंत्रण या केवल जोड़ें लॉग लंबे वर्कफ़्लो और मल्टी-एजेंट समन्वय का समर्थन करते हैं।
- टीमों को फ्रेमवर्क अपनाने से पहले मेमोरी प्रकार, लिखने के नियम, पुनर्प्राप्ति बिंदु और मीट्रिक जैसे रिकॉल, सटीकता, वफादारी और स्टेलनेस को परिभाषित करना चाहिए।
मेटा विवरण: जानें कि AI एजेंट मेमोरी कॉल, कार्य और सत्रों में संदर्भ को कैसे संग्रहीत करता है, पुनर्प्राप्त करता है और अपडेट करता है।
टैगः AI एजेंट मेमोरी, एजेंट स्मृति डिजाइन, स्मृति फ्रेमवर्क, बहु-एजेंट स्मृति, संदर्भ पुनर्प्राप्ति
विशेष रुप से प्रदर्शित छवि: एक स्वच्छ लेआउट में मेमोरी ब्लॉकों से जुड़े छोटे एजेंट आकार का अमूर्त मैत्रीपूर्ण चित्रण, जिसमें कोई दृश्य पाठ नहीं है।
AI एजेंट बनाने वाले डेवलपर्स के लिए, AI एजेन्ट मेमोरी वह परत है जो एक एजेंट को कॉल, कार्यों और सत्रों में जानकारी ले जाने की अनुमति देती है। एक भाषा मॉडल कॉल के बीच जानकारी नहीं रखता है, इसलिए प्रत्येक रन केवल वर्तमान अनुरोध में पाठ से शुरू होता है। यह एकल-प्रश्न के लिए काम करता है, लेकिन उन एजेंटों के लिए नहीं जिन्हें दोहराव वाली कार्रवाइयों से बचना चाहिए, वरीयताओं को याद रखना चाहिए, बहु-चरण कार्य जारी रखना चाहिए या असफल प्रयासों से सीखना चाहिए। स्मृति को डिज़ाइन किया जाना चाहिएः भंडारण, पुनर्प्राप्ति और अद्यतन नियम तय करते हैं कि क्या कोई एजेंट उपयोगी रहता है क्योंकि इसका वर्कलोड बढ़ता है।
क्यों स्मृति context window के बाहर रहना है
context window वह पाठ है जो एक मॉडल एक अनुरोध में देखता है. एक बार जब अनुरोध समाप्त हो जाता है, तो कुछ भी नहीं लिखा गया है। एजेंटों को चरणों के माध्यम से राज्य की आवश्यकता होती है, इसलिए मेमोरी उस विंडो के बाहर जानकारी संग्रहीत करती है और उपयोगी होने पर चयनित भाग वापस लाती है।
कोई एकल एजेंट मेमोरी तंत्र नहीं है। विभिन्न सूचनाओं को अलग-अलग भंडारण और पुनर्प्राप्ति पैटर्न की आवश्यकता होती है, और ये विकल्प लंबे समय तक कार्यों पर विश्वसनीयता को प्रभावित करते हैं।
स्मृति प्रकार और वे एक साथ कैसे काम करते हैं
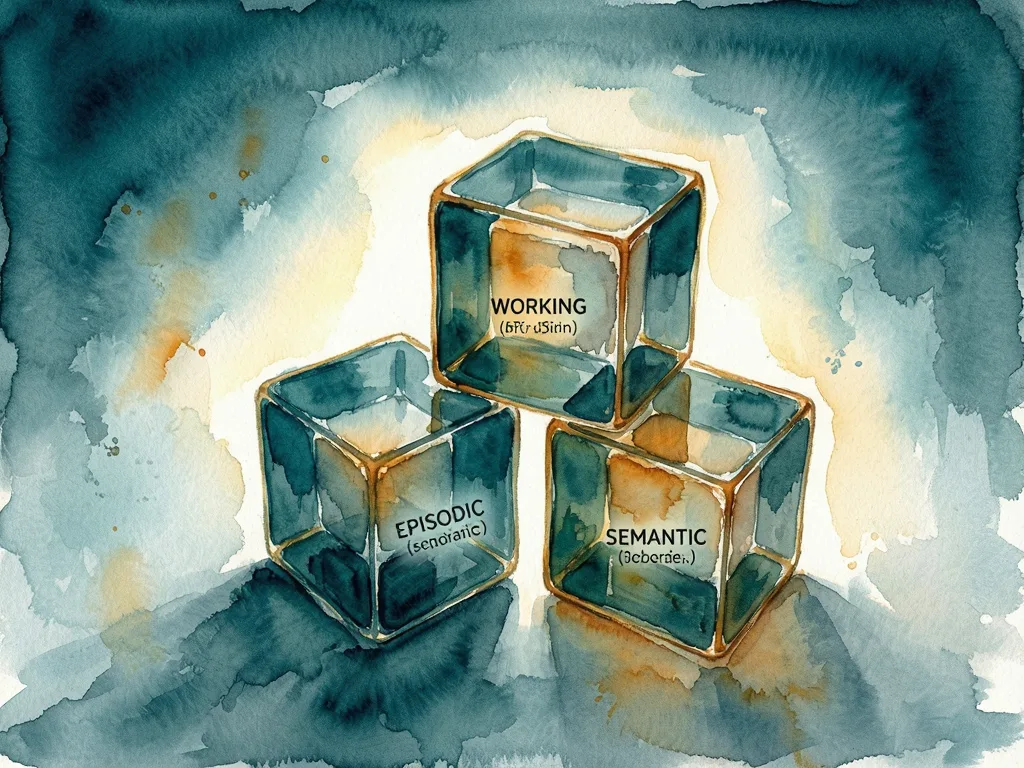
मुख्य स्मृति प्रकार कार्यशील स्मृति, एपिसोडिक मेमोरी और अर्थ संबंधी स्मृति हैं।
वर्किंग मेमोरी वह जानकारी है जो किसी एजेंट के पास उसके वर्तमान context window में होती है। अन्य प्रकार की स्मृति तय करती है कि उस संदर्भ में क्या लाया जाना चाहिए।
एपिसोडिक मेमोरी अतीत की घटनाओं को रिकॉर्ड करती है। यह एक एजेंट ने क्या प्रयास किया, क्या सफल हुआ, क्या विफल रहा और कौन सा परिणाम किसी विशेष कार्य या सत्र से संबंधित था। अर्थ संबंधी स्मृति संस्थाओं, उपयोगकर्ताओं या पर्यावरण के बारे में तथ्यों को रखती है, जैसे कि वरीयताएँ या स्थिर विशेषताएं जो एक घटना से परे उपयोगी रहती हैं।
एक शोध एजेंट जो कई दिनों तक काम करता है वह पैटर्न दिखा सकता है। प्रत्येक चरण के बाद, यह परिणाम को छोटी समाप्ति के साथ कार्यशील मेमोरी में लिखता है और इसे मेटाडेटा के साथ टैग करता है, जैसे कि उपकरण जिसने इसे उत्पन्न किया था और सत्र से संबंधित है। उपयोगी परिणामों को महत्व स्कोर के साथ एपिसोडिक स्मृति में बढ़ावा दिया जाता है। अस्थायी टिप्पणियों को छोड़ दिया जा सकता है, जबकि निर्णय जो बाद के चरणों को प्रभावित करते हैं वे बनाए रखे जाते हैं।
प्रत्येक टूल कॉल से पहले, एजेंट प्रासंगिक स्थिति के लिए वर्किंग मेमोरी की जांच करता है और जब अतिरिक्त संदर्भ की आवश्यकता होती है तो एपिसोडिक स्मृति खोजता है। पुनर्प्राप्ति केवल शुरुआत में ही नहीं, बल्कि निर्णय बिंदुओं पर होता है, क्योंकि जो जानकारी मायने रखती है वह कार्य प्रगति के रूप में बदल जाती है। यदि कार्य आधे रास्ते में विफल हो जाता है, तो एजेंट पूरा किए गए काम का एपिसोडिक रिकॉर्ड रखते हुए अस्थायी कार्य राज्य को छोड़ सकता है। जब यह फिर से शुरू होता है तो यह स्क्रैच से शुरू होने के बजाय उस इतिहास का उपयोग करता है।
डिजाइन पैटर्न जो स्मृति को विश्वसनीय बनाए रखते हैं
विश्वसनीय मेमोरी सिस्टम लिखने से पहले महत्व स्कोर करते हैं, इसलिए क्षणिक अवलोकन और कम मूल्य वाले टूल आउटपुट स्टोर को भीड़ नहीं देते। वे मल्टी-एजेंट सिस्टम में एजेंट की भूमिका द्वारा स्मृति का दायरा रखते हैं, प्रत्येक एजेंट को अपनी जिम्मेदारियों पर केंद्रित रखते हुए। वे कार्यप्रवाह के दौरान निर्णय बिंदुओं पर पुनर्प्राप्त करते हैं न कि केवल जब कार्य शुरू होता है। वे प्रकोष्ठ भी ट्रैक करते हैंः एजेंट, उपकरण, उपयोगकर्ता इनपुट या टाइमस्टैम्प जिसने प्रत्येक मेमरी का उत्पादन किया था। प्रस्थान प्रत्येक संग्रहीत आइटम की उत्पत्ति है, और यह डिबगिंग और ऑडिटिंग को आसान बनाता है।
एक आम विफलता स्मृति को एक असमान भंडार के रूप में व्यवहार करना है। यह अस्थायी नोट्स, महत्वपूर्ण तथ्यों और पुरानी घटनाओं का मिश्रण करता है। विश्वसनीय सिस्टम उद्देश्य से मेमोरी को अलग करते हैं, विभिन्न पुनर्प्राप्ति नियमों को लागू करते हैं और रिकॉर्ड करते हैं कि प्रत्येक संग्रहीत आइटम पर कितना भरोसा किया जाना चाहिए।
फ्रेमवर्क विकल्प, साझा स्मृति और मूल्यांकन
ये पैटर्न अलग-अलग मेमोरी फ्रेमवर्क पर बनाए जा सकते हैं, फ्लैट, टेक्स्ट-आधारित मैमोरी से लेकर स्ट्रक्चर्ड नॉलेज ग्राफ तक, जहां स्मृति को इकाइयों और रिश्तों के रूप में व्यवस्थित किया जाता है। यह विकल्प प्रभावित करता है कि संबंधित तथ्यों को कैसे पुनः प्राप्त किया जाए, संबंधों का प्रतिनिधित्व कैसे किया जाए और संग्रहीत जानकारी में परिवर्तन कैसे संभाले जाएं।
एक सरल मेमोरी परत तब काम करती है जब एजेंट को मुख्य रूप से हाल के संदर्भ या प्रासंगिक तथ्यों की आवश्यकता होती है। अधिक संरचित सिस्टम उपयोगी हो जाते हैं जब किसी एजंट को संस्थाओं के बीच संबंधों का पालन करने, कई तथ्यों पर तर्क देने या समय के साथ जानकारी कैसे बदलती है, इसे बनाए रखने की जरूरत होती है. यहां समीक्षा की गई सामग्री लेटा, मेम0, ग्राफिटी और कॉग्नी को विभिन्न भंडारण और पुनर्प्राप्ति व्यापार-ऑफ्स वाले फ्रेमवर्क उदाहरणों के रूप में इंगित करती है।
मल्टी-एजेंट सिस्टम एक और परत जोड़ते हैं। जब कई एजेंट एक ही मेमोरी को पढ़ते और लिखते हैं, तो समवर्ती अपडेट संघर्ष पैदा कर सकते हैं। सामान्य दृष्टिकोणों में लेखन नियंत्रण के साथ केंद्रीय स्मृति सेवा शामिल है, प्रत्येक एजेंट के लिए अलग नामस्थान या केवल लॉग जोड़े जाते हैं जहां पुनर्प्राप्ति के दौरान संघर्ष हल होते हैं।
जैसे-जैसे मेमोरी स्टोर्स बढ़ते हैं, टीमों को अंतर्ज्ञान के बजाय मैट्रिक्स की आवश्यकता होती है। पुनर्प्राप्ति रिकॉल जांचता है कि क्या प्रासंगिक यादें मौजूद होने पर पाई जाती हैं। पुनर्प्राप्त परिशुद्धता मापती है कि कितनी अप्रासंगिक जानकारी संबंधित यादों के साथ वापस आती है। वफादारी जाँचती है यदि एजेंट अपने तर्क में सही ढंग से पुनः प्राप्त जानकारी का उपयोग करता है या नहीं। स्टालेंनेस यह मापती है कि सिस्टम कितनी बार ऐसी जानकारी लेता है जो अब वर्तमान नहीं है।
आगे क्या करना है
सही मेमोरी दृष्टिकोण एजेंट के कार्यभार, डेटा और परिचालन आवश्यकताओं पर निर्भर करता है। छोटे कार्यों के लिए, एक बुनियादी स्टोर पर्याप्त हो सकता है। लंबे समय तक कार्यों, बहु-चरण अनुसंधान या कई एजेंटों को साझा करने की स्थिति के लिए स्मृति इंजीनियरिंग वास्तुशिल्प बन जाती है।
टीमों को एक फ्रेमवर्क जोड़ने से पहले मेमोरी प्रकार, लेखन नियम, पुनर्प्राप्ति बिंदुओं, उत्पत्ति और विफलता परीक्षण का चयन करके शुरू करना चाहिए। आगे पढ़ने में मल्टी-एजेंट मैमोरी इंजीनियरिंग पर MongoDB ब्लॉग टुकड़ा और स्मृति-जागरूक एजेंटों के निर्माण पर डीप लर्निंग.AI पाठ्यक्रम शामिल है।
Comments (0)