
शब्दों से लेकर वेक्टरों तकः बीच में क्या होता है?
टीएफ-आईडीएफ और वेक्टर स्पेस पाठ को भारित संख्यात्मक बिंदुओं में परिवर्तित करते हैं, वर्गीकरणकर्ताओं को दस्तावेजों की तुलना करने और समानता के आधार पर विषयों की पहचान करने में मदद करता है।
मुख्य जानकारी
- पाठ वर्गीकरण के लिए कच्चे पाठ को संख्यात्मक वेक्टरों में परिवर्तित करने की आवश्यकता होती है क्योंकि मॉडल सीधे शब्दों को नहीं पढ़ सकते हैं।
- TF-IDF उन शब्दों को वजन देकर सरल शब्द गणना में सुधार करता है जो एक दस्तावेज़ के भीतर सार्थक होते हैं लेकिन दस्तावेज सेट पर दुर्लभ होते हैं।
- वेक्टर स्पेस मॉडल दस्तावेजों को बिंदुओं में बदल देते हैं, जिससे वर्गीकरण समानता, दूरी या कोण के आधार पर एक ज्यामिति समस्या बन जाती है।
- TF-IDF मान कॉर्पस पर निर्भर करते हैं, और वेक्टर स्पेस सिमेंटिक अर्थ की गारंटी नहीं देते हैं, इसलिए प्रीप्रोसेसिंग और संदर्भ सीमाएं मायने रखती हैं।
- लेख पाठ वर्गीकरण को तीन-स्तर की प्रक्रिया के रूप में दर्शाता हैः प्रतिनिधित्व, वजन और लेबल किए गए उदाहरणों का उपयोग करके भविष्यवाणी।
मेटा विवरण: TF-IDF, वेक्टर स्पेस और टेक्स्ट क्लासिफिकेशन के लिए एक स्पष्ट मार्गदर्शिका, यह बताती है कि शब्द संख्या कैसे बनते हैं और शुरुआती लोगों के लिए मध्य चरण क्यों महत्वपूर्ण हैं।
टैगः TF-IDF, वेक्टर स्पेस, पाठ वर्गीकरण, प्राकृतिक भाषा प्रसंस्करण
विशेष रुप से प्रदर्शित छवि: शब्दों को संख्यात्मक वेक्टरों में बदलने और वर्गीकरण के लिए उपयोग किए जाने वाले स्थान पर रखे गए दस्तावेजों का अमूर्त मैत्रीपूर्ण चित्रण, कोई लोग नहीं, कोई लोगो नहीं, न ही पाठ।
यह मार्गदर्शिका उन पाठकों के लिए है जो यह समझना चाहते हैं कि कैसे TF-IDF और वेक्टर स्पेस कच्चे टेक्स्ट और मशीन लर्निंग को जोड़ते हैं। यह एक यात्रा पर आधारित है टीएफ-आईडीएफ, वेक्टर अंतरिक्ष और टेक्स्ट वर्गीकरण के माध्यम से, और शब्दों से लेकर वैक्टर तकः बीच में क्या होता है?
शब्दों और मॉडलों के बीच का लापता कदम
पाठ वर्गीकरण एक ऐसा कार्य है जहां एक प्रोग्राम दस्तावेजों को लेबल असाइन करता है, जैसे कि स्पैम या नॉन-स्पैम, सकारात्मक या नकारात्मक, या कई के बीच एक समाचार विषय। मॉडल शब्दों को उस तरह नहीं पढ़ सकते हैं जिस तरह से लोग करते हैं। उन्हें संख्यात्मक प्रतिनिधित्व की आवश्यकता होती है। यह स्रोत शीर्षक में मुख्य प्रश्न हैः इसके बीच क्या होता है?
एक वाक्य टोकन का अनुक्रम होता है, आमतौर पर शब्द या शब्दों जैसी इकाइयाँ। पहला काम उस क्रम को वेक्टर में बदलना है, संख्याओं की सूची। एक वेक्टर स्पेस ऐसे सभी वैक्टरों का संग्रह है। प्रत्येक दस्तावेज़ एक बिंदु बन जाता है, और समान दस्तावेज करीब बैठते हैं। यह उपयोगी है क्योंकि कई वर्गीकरण विधियां सीधे भाषा पढ़ने के बजाय बिन्दुओं में दूरी, कोण या पैटर्न को मापती हैं।
क्यों कच्चे शब्द गिनती बहुत क्रूर हैं
एक मूल वेक्टर गणना कर सकता है कि दस्तावेज़ में प्रत्येक शब्द कितनी बार प्रकट होता है। इसे टर्म फ्रीक्वेंसी कहा जाता है। यह एक दस्तावेज के भीतर महत्व को पकड़ता है, लेकिन यह पूरे संग्रह में महत्व से चूक सकता है। शब्द the कई दस्तावेजों में अक्सर दिखाई दे सकता है, इसलिए यह विषयों को अलग करने में मदद नहीं करता है। सामान्य संग्रह में चालान शब्द दुर्लभ हो सकता है लेकिन स्पैम या वित्त दस्तावेज में आम है, तो यह अधिक संकेत लेता है।
TF-IDF, या टर्म फ्रीक्वेंसी इनवर्स डॉक्यूमेंट फ्रिक्वेंसी, इसके लिए समायोजित करता है. यह दो विचारों को गुणा करता हैः एक दस्तावेज़ में कोई शब्द कितना मायने रखता है और दस्तावेज सेट पर इसका कितना महत्व है। हर जगह दिखाई देने वाला शब्द कम हो जाता है। जो शब्द कम दस्तावेजों में केंद्रित होता है वह बढ़ाया जाता है. परिणाम महत्त्व की एक शब्दकोश परिभाषा नहीं है। यह पाठ डेटा के लिए एक व्यावहारिक वजन योजना है।
पाठ वर्गीकरण के लिए वेक्टर स्पेस क्या देता है
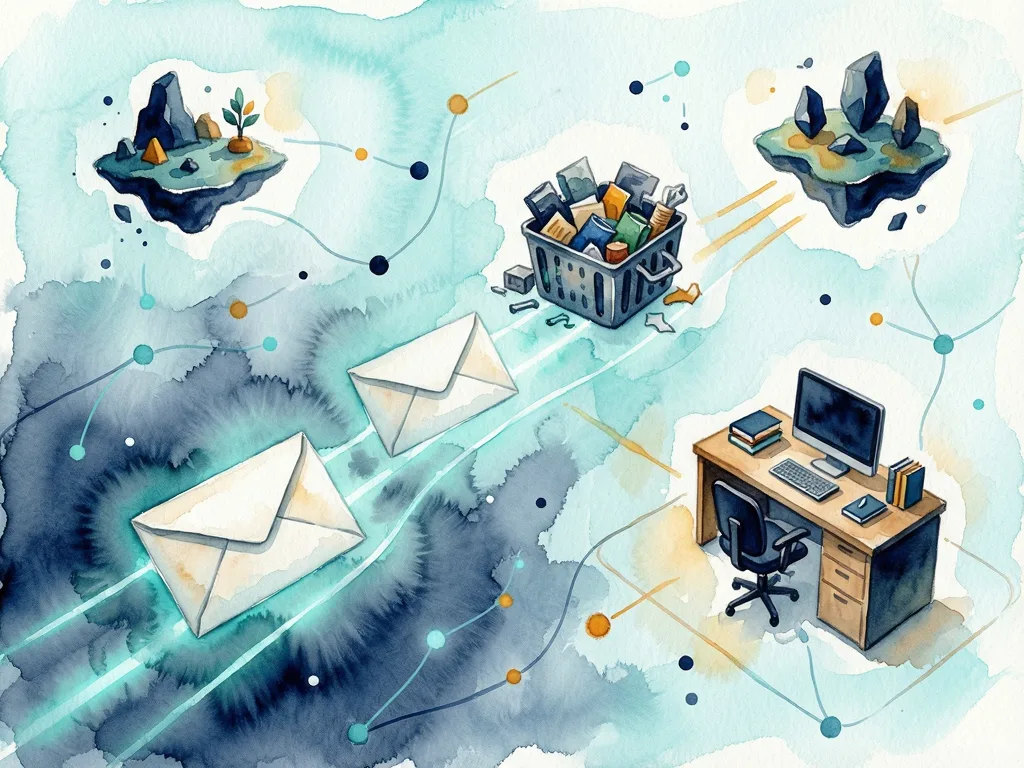
एक बार जब प्रत्येक दस्तावेज़ में TF-IDF वेक्टर होता है, तो वर्गीकरण एक ज्यामिति समस्या बन जाती है। एक मॉडल पहले से ही लेबल वाले उदाहरणों के साथ एक नए दस्तावेज़ की तुलना कर सकता है। यदि नए दस्तावेज़ में अनसब्सक्राइब, डील और क्लिक जैसे शब्दों पर मजबूत वजन हो, तो यह लेबल किए गए स्पैम के पास बैठ सकता है. अगर इसमें मीटिंग, एजेंडा और बजट जैसे शब्द हैं, तो वह काम ईमेल के पास बैठेगा।
यही कारण है कि वेक्टर स्पेस मायने रखता है. यह मॉडल को समानता की तलाश करने के लिए एक जगह देता है। यह पाठकों को मानसिक मॉडल भी देता हैः वर्गीकरण जादू पढ़ना नहीं है, लेकिन शब्द महत्व से आकार वाले स्थान में पैटर्न मिलान।
आम भ्रम के बिंदु
TF-IDF प्रत्येक शब्द के लिए एक एकल स्कोर नहीं है। यह दस्तावेज़ सेट पर निर्भर करता है। एक ही शब्द का विभिन्न संग्रहों में अलग-अलग वजन हो सकता है। इसके अलावा, वेक्टर स्पेस अर्थ की गारंटी नहीं देता है. यह डेटा में संदर्भ द्वारा शब्दों को मैप करता है, इसलिए दुर्लभ शब्द या वर्तनी त्रुटियां अंतराल बना सकती हैं। अच्छा पूर्व प्रसंस्करण, जैसे कि लोअरकेसिंग, टोकनाइजिंग और स्पष्ट शोर हटाने से मदद मिलती है, लेकिन यह सभी समस्याओं को हल नहीं करती है।
पाठकों को आगे क्या ध्यान देना चाहिए
स्रोत विषय को TF-IDF, वेक्टर स्पेस और टेक्स्ट क्लासिफिकेशन के माध्यम से एक यात्रा के रूप में फ्रेम करता है। यह फ़्रेमिंग उपयोगी है क्योंकि यह तीन परतों को अलग करती है जिन्हें अक्सर एक साथ पढ़ाया जाता है। पहली परत प्रतिनिधित्व हैः शब्द कैसे संख्या बन जाते हैं। दूसरा भारित करना हैः दुर्लभ लेकिन सार्थक शब्दों का अधिक प्रभाव पड़ता है। तीसरा उपयोगः लेबल किए गए उदाहरण भविष्यवाणियों को कैसे निर्देशित करते हैं।
शुरुआती लोगों के लिए, व्यावहारिक मूल्य सरल है। यदि एक पाठ मॉडल खराब प्रदर्शन करता है, तो समस्या केवल वर्गीकरणकर्ता नहीं हो सकती है। वेक्टर बहुत विरल, बहुत शोरपूर्ण या बहुत ही सामान्य शब्दों और छोटे वाक्यांशों पर निर्भर हो सकता है। अगर कोई मॉडल काम करता है तो TF-IDF और वेक्टर स्पेस भाषा को तुलनीय बनाने का शांत काम कर सकते हैं।
Comments (0)