
अनुकूली गणना LLMs को कुशल सिस्टम वन मॉडल में बदल देती है
नेस्टोन प्रारंभिक निकास और साझा परतों के साथ एक LLM को प्रशिक्षित करता है, जिससे निर्णय आवश्यक गहराई पर रुकते हैं और सटीकता बनाए रखते हुए गणना में कटौती करते हैं।
मुख्य जानकारी
- नेस्टोन LLM -आधारित निर्णय मॉडल को अनुकूली बनाता है जो उन्हें हमेशा पूर्ण रीढ़ की हड्डी चलाने के बजाय जल्दी बाहर निकलने की अनुमति देता है।
- यह संयुक्त रूप से अंतिम परतों और निर्णय सिर को साझा करते हुए स्व-निष्कासन के माध्यम से छोटे उपसर्ग सबमॉडल के साथ एक पूर्ण मॉडल को प्रशिक्षित करता है।
- एक हल्का गेट प्रत्येक निकास पर छिपी हुई स्थितियों को पढ़ता है यह तय करने के लिए कि क्या अधिक गणना की आवश्यकता है, इसलिए आसान निर्णय कम परतों का उपयोग करते हैं।
- सात निर्णय बेंचमार्क में, नेस्टोन स्वतंत्र रूप से प्रशिक्षित मॉडल के साथ मेल खाता है या बेहतर प्रदर्शन करता है जबकि सटीकता-दक्षता ट्रेडऑफ को बढ़ाता है।
- परिणाम बताते हैं कि निर्णय से संबंधित जानकारी प्रारंभिक और मध्यवर्ती परतों में केंद्रित है, जिससे मॉडल की गहराई एक ट्यून करने योग्य संसाधन बन जाती है।
मेटा विवरणः नेस्टोन LLM को प्रारंभिक निकास और साझा अंतिम परतों के साथ प्रशिक्षित करता है, इसलिए निर्णय कार्य सात बेंचमार्क में सटीकता बनाए रखते हुए कम परतों का उपयोग कर सकते हैं।
टैगः नेस्टोन, LLM, अनुकूली गणना, निर्णय मॉडल, स्व-निष्कासन
विशेष रुप से प्रदर्शित छवि: प्रारंभिक निकास द्वारों और साझा अंतिम परतों के साथ एक स्तरित neural network , बिना पाठ, लोगों या लोगो के।
नेस्टोन एक छोटे मॉडल को स्क्रैच से प्रशिक्षित किए बिना LLM निर्णय-कार्य गणना कम करता है; प्रमुख परतों को संरक्षित करते हुए एक प्रशिक्षित मॉडल प्रति निर्णय गहराई चुनता है।
पूर्ण गहराई क्यों अति घातक हो सकती है
System One निर्णय LLMs भाषा मॉडलिंग सिर को एक निर्णय के साथ बदलें लेकिन पूरी रीढ़ की हड्डी रखें, इसलिए प्रत्येक निर्णय सभी परतों के लिए भुगतान करता है भले ही केवल भाग की आवश्यकता हो।
आवश्यक जानकारी मध्यवर्ती परतों में केंद्रित होती हैः प्रारंभिक परतें महत्वपूर्ण विशेषताएं बनाती हैं, जबकि अंतिम छह परतों को बिना नुकसान के हटाया जा सकता है। स्वतंत्र रूप से प्रशिक्षित छोटे मॉडल विशेष निर्णय क्षमताओं को विकसित करने के बजाय बड़े पैमाने पर पूर्ण मॉडल की नकल करते हैं, इसलिए रीढ़ की हड्डी को छोटा करना पर्याप्त नहीं है; गहराई में कंप्यूटेशन साझा करना शुरुआती निकास अलग-अलग कमजोर मॉडल बनने के बजाय उपयोगी परतों का पुनः उपयोग करता है।
कैसे नेस्टोन जल्दी निकलता है
नेस्टोन संयुक्त रूप से एक पूर्ण मॉडल को उप-मॉडल के साथ प्रशिक्षित करता है जो अंतिम परतों और स्व-निष्कासन के माध्यम से निर्णय सिर साझा करते हैं। पूर्ण मॉडल का व्यवहार छोटे सबमॉडलों को जल्दी रुकने पर संरेखित करने के लिए ट्रेन करता है।
एक हल्का गेट प्रत्येक निकास पर छिपी हुई स्थिति (उस परत तक निर्मित प्रतिनिधित्व) को पढ़ता है ताकि यह तय किया जा सके कि अधिक गणना की आवश्यकता है या नहीं। यदि प्रतिनिधित्व पर्याप्त है, तो मॉडल बाहर निकल जाता है; अन्यथा यह जारी रहता है। यह अनुकूली कंप्यूटेशन हर इनपुट को उसी पथ के माध्यम से मजबूर करने के बजाय कई गहराई पर एक मॉडल संचालित करता है।
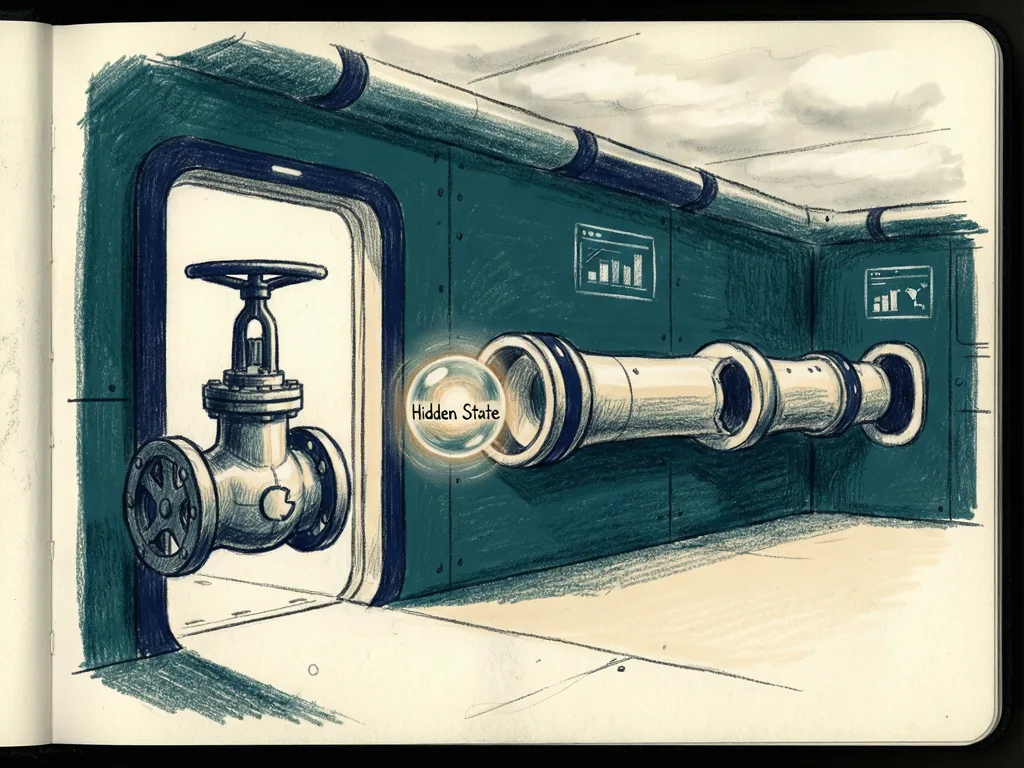
छोटे मॉडल में स्वैपिंग के विपरीत, नेस्टोन रीढ़ की हड्डी और अंतिम परतों को साझा करता है और पुनः प्रयोज्य निकास जोड़ता है। हल किए गए निर्णय कम कंप्यूटिंग का उपयोग करते हैं; कठिन निर्णय जारी रहते हैं।
सात बेंचमार्क क्या दिखाते हैं
सात निर्णय बेंचमार्क में, नेस्टोन प्रत्येक गहराई पर स्वतंत्र रूप से प्रशिक्षित मॉडलों के साथ मेल खाता है या बेहतर प्रदर्शन करता है, सटीकता-दक्षता व्यापारों को सुधारते हुए हर गहराई की सटीकता बनाए रखता है क्योंकि गणना तब रुक जाती है जब गेट कहता है कि यह अनावश्यक है।
यह इस विचार का समर्थन करता है कि निर्णय की जानकारी समान रूप से वितरित नहीं होती हैः प्रारंभिक परतें आवश्यक विशेषताएं बनाती हैं और मध्यवर्ती परतें बहुत अधिक सिग्नल ले जाती हैं, इसलिए सभी परतों को निष्पादित करने के लिए कंप्यूटिंग अपशिष्ट; बिना नुकसान के अंतिम छह स्तरों को हटाने से कुछ गहराई दिखाई देती है।
LLM निर्णय प्रणालियों के लिए, प्रत्येक इनपुट की आवश्यक गहराई पर विचार करें, न कि केवल एक छोटे मॉडल। नेस्टोन से पता चलता है कि एक मॉडल साझा गणना और हल्के गेट का उपयोग करके कई निर्णय पथ ले सकता है ताकि यह तय किया जा सके कि कब रोकना है, सटीकता बनाए रखना या सुधार करना जबकि गहराई को ट्यून करने योग्य संसाधन बनाना, निश्चित लागत नहीं।
Comments (0)