
एजेंट व्यवहार का पता लगाना: दीर्घ-क्षितिज एजेंटों के लिए साक्ष्य आधारित पर्यवेक्षण
यह पेपर साक्ष्य-आधारित पर्यवेक्षण, एजेंटमोनबेंच और ईबीजी का प्रस्ताव करता है ताकि उपयोगकर्ताओं को सत्यापित करने में मदद मिल सके कि लंबी क्षितिज AI एजेंटों ने वास्तव में क्या किया था।
मुख्य जानकारी
- कागज उपयोगकर्ताओं को यह समझने में मदद करने के लिए साक्ष्य-आधारित पर्यवेक्षण का प्रस्ताव करता है कि लंबी क्षितिज AI एजेंटों ने वास्तव में क्या किया, न कि उन्होंने एक कार्य पूरा किया या नहीं।
- यह एजेंट कार्यप्रवाह में प्रमुख पर्यवेक्षण जोखिमों की पहचान करता है, जिसमें अंडर-निर्दिष्ट आवश्यकताएं, मूक व्यवहार संबंधी विचलन और असत्यापित परिणामी निर्णय शामिल हैं।
- AgentMonBench मूल्यांकन करता है कि क्या LLMs महत्वपूर्ण एजेंट विकल्पों का पता लगा सकता है और लॉग, टूल कॉल, कोड परिवर्तन और कलाकृतियों के माध्यम से समर्थन सबूत ढूंढ सकता है।
- साक्ष्य-Grounded Behavior Graph एक संरचित ग्राफ में बिखरे हुए निष्पादन प्रमाण को व्यवस्थित करता है जो कार्य आवश्यकताओं, एजेंट कार्यों, परिवर्तनों और स्रोतों को जोड़ता है।
- यह दृष्टिकोण प्रशिक्षण-मुक्त है और आवश्यकता स्पष्टीकरण, व्यवहार समीक्षा और साक्ष्य आधारित परिणाम सत्यापन का समर्थन करने के लिए चेकपॉइंट्स के साथ Codex Harness में एकीकृत है।

मेटा विवरण: जानें कि साक्ष्य-आधारित पर्यवेक्षण उपयोगकर्ताओं को AgentMonBench, EBG और Codex Harness चेकपॉइंट्स के साथ दीर्घकालिक AI एजेंट निर्णयों पर नज़र रखने में कैसे मदद करता है।
टैगः AI एजेंट पर्यवेक्षण, दीर्घ क्षितिज एजेंटों, साक्ष्य आधारित मूल्यांकन, AgentMonBench, EBG
स्वायत्त AI एजेंटों का उपयोग या निर्माण करने वाले किसी भी व्यक्ति के लिए, हाल ही में एक कागज एक व्यावहारिक प्रश्न का उत्तर देने के तरीके के रूप में साक्ष्य-आधारित पर्यवेक्षण पेश करता हैः एजेंट ने वास्तव में क्या किया? पेपर, "What Did the Agent Actually Do? Evidence-Grounded Oversight for Long- Horizon Agents", AgentMonBench प्रस्तुत करता है, यह जांचने के लिए एक बेंचमार्क कि क्या large language models , या LLMs , महत्वपूर्ण विकल्पों को देख सकते हैं और उन लॉग्स को ढूंढ सकते हैं जो उनका समर्थन करते हैं।
एजेंट पर्यवेक्षण एक व्यवहारिक समस्या क्यों बन रहा है
मूल मुद्दा यह नहीं है कि AI एजेंट सरल हैं। वे अधिक सक्षम हो रहे हैं, एकल प्रश्नों या अलग-थलग उपकरण कॉल से आगे बढ़कर वर्कफ़्लो में जा सकते हैं जो घंटों या दिनों तक चल सकता है। software विकास, डेटा विश्लेषण और वैज्ञानिक अनुसंधान में, एजेंट अपने दम पर योजना बना सकते हैं, टूल को लागू करते हैं, कोड को संशोधित कर सकते हैं और परिणाम आने के साथ रणनीति बदल सकते हैं।
यह क्षमता एक पर्यवेक्षण अंतर पैदा करती है। Traditional AI व्याख्यात्मकता अनुसंधान इस बात पर ध्यान केंद्रित किया गया है कि कोई मॉडल आंतरिक निर्णय कैसे लेता है। लंबी क्षितिज एजेंटों के लिए, कठिन सवाल अलग हो सकता हैः उपयोगकर्ता कैसे बता सकता है कि एजेंट ने वास्तव में कई चरणों में क्या किया? समस्या यह है कि एक घोषित लक्ष्य पूर्ण अनुबंध नहीं है। एजेंट को अंतराल भरने, विकल्पों के बीच चयन करने या कुछ विफल होने पर अनुकूलित करने की आवश्यकता हो सकती है।
पेपर में तीन विफलता मोड पर प्रकाश डाला गया है जो बिना किसी स्पष्ट त्रुटि के भी हो सकते हैं। सबसे पहले, अंडरस्पेसिफाइड आवश्यकताएंः यदि कोई उपयोगकर्ता निर्देश अधूरा है, तो एजेंट ऐसी धारणाएँ बना सकता है जो उपयोगकर्ता के वास्तविक इरादे से मेल नहीं खाते। दूसरा, मूक व्यवहार संबंधी विचलन: एजेंट उपयोगकर्ता को बताए बिना अपनी योजना या कार्यान्वयन बदल सकता है, और उत्तीर्ण परीक्षण अंतर का खुलासा नहीं कर सकता है। तीसरा, अप्रमाणित परिणामी निर्णयः मूल्यांकन मीट्रिक बदलने, डेटा फ़िल्टरिंग, या प्रयोगात्मक सेटिंग्स को समायोजित करने जैसे विकल्प अंतिम परिणाम की पुष्टि किए बिना फिर से आकार दे सकते हैं.
जैसे-जैसे निष्पादन के निशान लंबे होते जाते हैं, इन निर्णयों का प्रमाण वार्तालाप मोड़, टूल कॉल, कोड परिवर्तन और मध्यवर्ती कलाकृतियों में फैल जाता है। एक उपयोगकर्ता हर कदम को यथार्थवादी रूप से नहीं पढ़ सकता है। यह पारंपरिक मानव-इन-द-लूप पर्यवेक्षण के लिए एक चुनौती पैदा करता हैः कोई व्यक्ति नाममात्र में लूप में रह सकता है जबकि अभी भी जो मायने रखता है उसे याद कर रहा है।
क्या नई पर्यवेक्षण प्रणाली का पता लगाने के लिए बनाया गया है
पेपर दो संबंधित प्रश्नों के आसपास कार्य को फ्रेम करता है। पहला संरेखण हैः क्या एजेंट का अवलोकन किया गया व्यवहार उपयोगकर्ता की आवश्यकताओं से मेल खाता है? इसमें ऐसे मामले शामिल हैं जहां मूल अनुरोध ने महत्वपूर्ण विवरण अनसुलझे छोड़ दिए थे, या जहां एजेंट इच्छित पथ से भटक गया था। पर्यवेक्षण प्रणाली को उन मुद्दों को चिह्नित करना चाहिए जिन्हें स्पष्टीकरण या सत्यापन की आवश्यकता हो सकती है।
दूसरा प्रश्न परिणामी निर्णयों के बारे में जागरूकता है: एजेंट ने कौन से विकल्प बनाए जो परिणाम को प्रभावित कर सकते हैं? सिस्टम को तब भी निर्णय लेने चाहिए जब वे स्पष्ट रूप से गलत न हों। dataset फ़िल्टर, एक मीट्रिक परिभाषा या एक प्रयोगात्मक सेटिंग में बदलाव उचित हो सकता है, लेकिन यह अभी भी मानव जांच का हकदार है क्योंकि यह अंतिम उत्तर निर्धारित कर सकता है।
यह भेद रोजमर्रा के एजेंट उपयोगकर्ताओं के लिए महत्वपूर्ण है। एक उपयोगी पर्यवेक्षण उपकरण केवल यह नहीं पूछना चाहिए कि क्या एजेंट ने परिणाम का उत्पादन किया। इसे उपयोगकर्ता को यह देखने में मदद करनी चाहिए कि कौन से निर्णयों ने उस परिणाम को आकार दिया और जहां सहायक साक्ष्य रहते हैं।
कैसे AgentMonBench और EBG लॉग को एक समीक्षा योग्य ट्रेल में बदलते हैं
प्रगति को मापने के लिए, कागज AgentMonBench का परिचय देता है। बेंचमार्क में तीन उप-समूह हैंः SpecGAP, SilentSwap और FeedbackTrace. एक साथ, उनका मूल्यांकन करना है कि क्या large language models परिणामी निर्णयों की पहचान कर सकता है और एजेंट वर्कफ़्लो में सहायक साक्ष्य ढूंढ सकता है या नहीं।
प्रस्तावित विधि साक्ष्य-Grounded Behavior Graph, ईबीजी है। इसका मूल विचार रिपॉजिटरी और निष्पादन प्रक्षेपवक्र से बिखरे हुए सबूतों को एक संरचित व्यवहारिक ग्राफ में व्यवस्थित करना है। किसी मानव को कच्चे लॉग के माध्यम से खोज करने के लिए मजबूर करने के बजाय, ग्राफ कार्य आवश्यकताओं, एजेंट कार्यों, परिवर्तनों और प्रमाण स्रोतों को इस तरह से जोड़ता है कि एक पर्यवेक्षण मॉडल निरीक्षण कर सके।
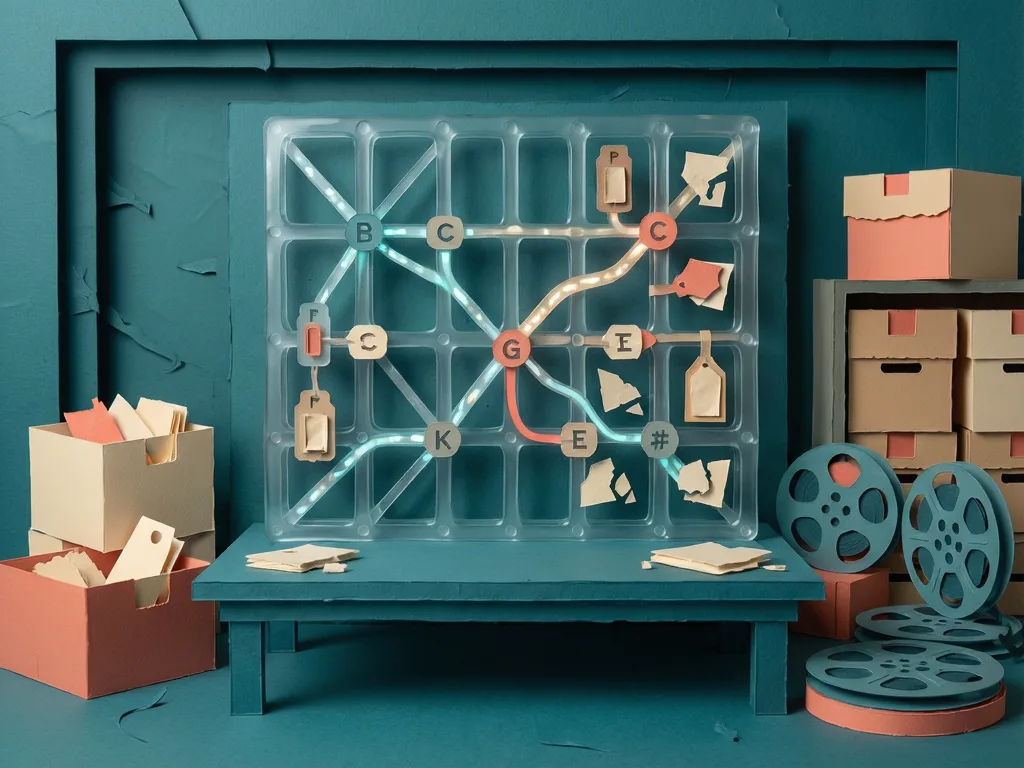
ईबीजी को प्रशिक्षण-मुक्त के रूप में वर्णित किया गया है। इसे मौजूदा मॉडलों के साथ जोड़ा जा सकता है ताकि निर्णयों का पता लगाया जा सके और उन्हें उनके मूल स्रोतों पर वापस लाया जा सके। पेपर Codex Harness में दृष्टिकोण को भी एकीकृत करता है, निष्पादन से पहले पर्यवेक्षण चेकपॉइंट्स डालता है, परिणामी कार्यान्वयन परिवर्तनों के बाद, और अंतिम रिपोर्टिंग से पहले। इन जांच बिंदुओं का उद्देश्य उपयोगकर्ताओं को आवश्यकताओं को स्पष्ट करने, महत्वपूर्ण व्यवहारिक परिवर्तनों की समीक्षा करने और साक्ष्य के साथ परिणामों को सत्यापित करने में मदद करना है।
प्रयोग क्या सुझाव देते हैं, और वे क्या दावा नहीं करते
प्रयोगों ने आठ मॉडलों में व्यवहार की तुलना की। पेपर रिपोर्ट करता है कि ईबीजी अधिकांश मूल्यांकन सेटिंग्स में परिणामी निर्णय पहचान और साक्ष्य स्थानीयकरण में सुधार करता है। परिणाम एक उपयोगी दिशा में इंगित करते हैं, लेकिन इसका मतलब यह नहीं है कि पर्यवेक्षण हल हो गया है। बेंचमार्क एक विशिष्ट कौशल को मापता हैः महत्वपूर्ण फैसलों को स्पॉट करना और सबूत ढूंढना। वास्तविक उपयोगकर्ता वर्कफ़्लो गड़बड़ होते हैं, और हर जोखिम भरा निर्णय लॉग में नाटकीय रूप से दिखाई नहीं देगा।
वास्तविक शोध कार्यप्रवाहों से जुड़े केस स्टडी को यह दिखाने के लिए शामिल किया गया है कि कैसे सिस्टम सत्यापन का समर्थन कर सकता है और बाद में एजेंट निष्पादन को निर्देशित कर सकते हैं। ये उदाहरण इच्छित वर्कफ़्लो की व्याख्या करते हैंः एक मानव समीक्षाएं हाइलाइट किए गए निर्णय और साक्ष्य, फिर स्वीकार करने, समायोजित करने या हस्तक्षेप करने का फैसला करता है।
क्यों यह बदल सकता है कि लोग स्वायत्त एजेंटों का उपयोग कैसे करते हैं
व्यापक संदेश व्याख्यात्मकता में एक बदलाव है। लंबी क्षितिज एजेंटों के लिए, सवाल केवल "मॉडल ने आंतरिक रूप से इस तरह का तर्क क्यों नहीं किया?" यह भी है कि "एजेंट वास्तव में क्या करता था, कौन से निर्णय परिणाम को आकार देते हैं, और उन फैसलों का समर्थन करने वाले कौन से सबूत? "यह रीफ्रेमिंग पर्यवेक्षण उपयोगकर्ताओं के लिए अधिक ठोस बनाता है।
डेवलपर्स और शोधकर्ताओं के लिए, मूल्य व्यावहारिक हैः निष्क्रिय लॉग समीक्षा से लक्षित सत्यापन पर जाने का एक तरीका। कोडिंग, विश्लेषण या अनुसंधान में एजेंटों के उपयोगकर्ताओं के लिए इसका तात्पर्य यह है कि अगली ट्रस्ट लेयर अनुमतियों की लंबी सूची या बड़ा संकेत नहीं हो सकता है। यह एक ऐसी प्रणाली हो सकती है जो उन्हें सही समय पर बताती है, क्या बदल गया है, क्यों मायने रख सकता है, और इसे कहां जांचना है।
यह पेपर उपलब्ध है arXiv: 2610.06406कोड उपलब्ध है zhk-lab/EBG, में बेंचमार्क झाओहोंगकांग/एजेंटमोनबेंच, और परियोजना पृष्ठ पर zhk-lab.github.io/agentmonbench-ebg.
Comments (0)