
RynnVLA-Latent तीन आयामी अंतरिक्ष में गुप्त क्रियाओं को ग्राउंडिंग करके रोबोटिक हेरफेर फाउंडेशन मॉडल को स्केल करता है।
RynnLAM 30,100 घंटे के मानव, robot, और सिमुलेशन वीडियो से गुप्त कार्रवाई लक्ष्य बनाता है; RynnVLA-Latent उन्हें वास्तविक robot नियंत्रण में स्थानांतरित करता है।
मुख्य जानकारी
- RynnVLA-Latent ने मूल रोबोट-एक्शन लेबल की आवश्यकता के बजाय 30.1K घंटे के मिश्रित वीडियो से रोबोट हेरफेर नीतियों को सीखा है।
- RynnLAM अवशिष्ट विशेषता पूर्वानुमान, कैमरा-संतुलित 3 डी प्रवाह पर्यवेक्षण और कैमरा गति विघटन का उपयोग करके गुप्त कार्रवाई निगरानी प्रदान करता है।
- विधि दो-चरण पथ का अनुसरण करती हैः पहले वीडियो से साझा किए गए 3 डी ग्राउंडेड संक्रमण प्रतिनिधित्वों को सीखें, फिर उन्हें विशिष्ट रोबोट के लिए अवतार-विशिष्ट पोस्ट-प्रशिक्षण के माध्यम से अनुकूलित करें।
- सत्यापन में सिमुलेशन और वास्तविक दुनिया के प्लेटफार्मों पर जमे हुए-प्रतिनिधित्व जांच और हेरफेर परीक्षण सहित प्रतिनिधित्व गुणवत्ता और नीति प्रदर्शन शामिल है।
- यह दृष्टिकोण अधिक वीडियो विविधता के साथ स्केल करता है और महंगे, संकीर्ण रूप से एकत्रित रोबोट-एक्शन डेटासेट पर निर्भरता को कम कर सकता है।
मेटा विवरण: RynnLAM और RynnVLA-Latent 30.1K घंटे के वीडियो से लुप्त क्रियाओं को सीखते हैं, फिर सिमुलेशन और वास्तविक दुनिया प्लेटफार्मों में रोबोट नियंत्रण स्थानांतरित करते हैं।
टैग: RynnLAM, RynnVLA-Latent, गुप्त क्रिया पर्यवेक्षण, वीडियो पूर्व प्रशिक्षण, रोबोट हेरफेर
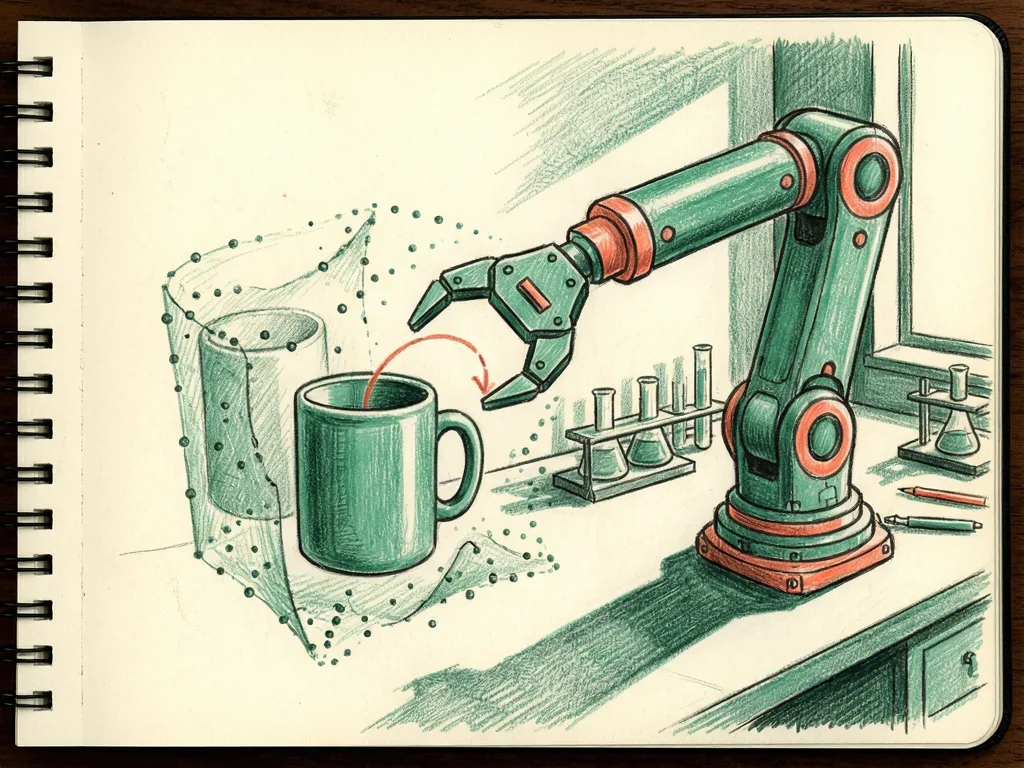
चित्र: वीडियो फ्रेम, कैमरा मोशन तीरों और रोबोट बाहों का अमूर्त मैत्रीपूर्ण चित्रण जो नरम गुप्त-क्रिया रेखाओं से जुड़ा हुआ है।
रोबोट सीखने वाले पाठकों के लिए, मूल तथ्य सीधा हैः RynnVLA-Latent को 30.1K घंटे के मिश्रित वीडियो से एक रोबोट नियंत्रण नीति बनाने के लिए बनाया गया है, जबकि RynnLAM पर्यवेक्षण प्रदान करता है जो लापता रोबोट क्रियाओं के लिए वीडियो खड़ा करने देता है। देशी रोबोट-एक्शन लेबल की आवश्यकता के बजाय, विधि निरंतर संक्रमण प्रतिनिधित्व का निर्माण करती है जो समय के साथ दृश्य राज्यों में परिवर्तन कैसे कैप्चर करते हैं। योगदान दो चरणों वाला मार्ग है - पहले मानव, रोबोट और सिमुलेशन वीडियो से लुप्त कार्रवाई लक्ष्यों को सीखें, फिर पूर्व-प्रशिक्षित नीति को विशिष्ट रोबोट के लिए अवतार-विशिष्ट पोस्ट-ट्रेनिंग के माध्यम से अनुकूलित करें।
लेबल किए गए रोबोट क्रियाएं क्यों बाधा हैं
रोबोट नीतियों को आमतौर पर चित्रों से अधिक की आवश्यकता होती है। यह जानने के लिए कि हेरफेर कैसे काम करता है, एक मॉडल को अक्सर सटीक मोटर कमांड्स की जरूरत होती है जिसके कारण रोबोट किसी ऑब्जेक्ट को स्थानांतरित करने, पकड़ने या पुनर्निर्देशित करने का कारण बनता है। इस आवश्यकता से रोबोट डेटा महंगा और संकीर्ण हो जाता है, क्योंकि प्रत्येक क्लिप एक विशेष मशीन, सेंसर सेटअप और नियंत्रण इंटरफ़ेस से जुड़ा होता है।
वीडियो गति का एक बहुत व्यापक स्रोत प्रदान करता है, लेकिन कच्चे वीडियो रोबोट कार्यों के लिए एक स्वच्छ विकल्प नहीं हैं। मानव वीडियो में रोबोट मोटर कमांड के बिना समृद्ध हेरफेर दिखाया गया है। सिमुलेशन क्लिप में ऐसी गति हो सकती है जो यथार्थवादी लगती है लेकिन वास्तविक दुनिया भौतिकी या कैमरा व्यवहार से मेल नहीं खा सकती है। रोबोट वीडियो तैनाती के करीब हैं, फिर भी वे उन मशीनों की संख्या द्वारा सीमित हैं जो उन्हें एकत्र कर सकते हैं। योगदान पहले वीडियो से आंतरिक, कार्रवाई-जैसे संकेत सीखकर इस अंतर को संबोधित करता है और बाद में उस सिग्नल को रोबोट के अपने नियंत्रण से जोड़ता है।
RynnLAM गुप्त-क्रिया पुल का निर्माण करता है
RynnLAM पर्यवेक्षण परत है जो वीडियो को प्रयोग करने योग्य प्रशिक्षण लक्ष्यों में बदल देती है। यह अवशिष्ट सुविधा भविष्यवाणी, कैमरा-संतुलित 3 डी प्रवाह पर्यवेक्षक और कैमरा गति विघटन का संयोजन करता है ताकि देशी रोबोट-एक्शन लेबल के बिना निरंतर संक्रमण प्रतिनिधित्व का निर्माण किया जा सके।
अवशिष्ट सुविधा पूर्वानुमान प्रत्येक फ्रेम को एक अलग छवि के रूप में व्यवहार करने के बजाय, दृश्य राज्यों के बीच क्या परिवर्तन होते हैं, इस पर ध्यान केंद्रित करने में मॉडल की मदद करता है। कैमरा-संतुलित 3 डी प्रवाह पर्यवेक्षण उस तथ्य के लिए समायोजन करते हुए दृश्य में गति का उपयोग करता है कि कैमरा स्वयं आगे बढ़ रहा हो सकता है। Camera-motion decoupling further separates camera movement from object and body movement.
साथ में, ये घटक संक्रमणों का एक अधिक स्थिर आंतरिक प्रतिनिधित्व बनाते हैं. यह महत्वपूर्ण है क्योंकि रोबोट को वीडियो स्रोत से मूल मोटर कमांड जानने की आवश्यकता नहीं होती है। इसे ऐसे प्रतिनिधित्व की आवश्यकता होती है जो भविष्यवाणी करता है कि दुनिया कैसे बदलती है और बाद में अपने स्वयं के नियंत्रण स्थान पर मैप किया जा सकता है।
RynnVLA-विभिन्न प्रकार के वीडियो में अव्यक्त तराजू
दूसरी प्रणाली, RynnVLA-Latent, उन प्रतिनिधित्वों को साझा किए गए गुप्त कार्रवाई लक्ष्यों के रूप में उपयोग करती है। यह 30.1K घंटे के विषम विडियो से सीखता है, एक प्रशिक्षण पूल जिसमें मानव वीडियो, रोबोट वीडियो और सिमुलेशन वीडियो शामिल हैं। विधि मानती नहीं है कि सभी तीन स्रोतों का उपयोग किया जा सकता है जैसे कि वे समान रोबोट डेटासेट थे। इसके बजाय, यह सामान्य संक्रमण पैटर्न निकालेगा जो विभिन्न डेटा स्रोतों पर पुनः उपयोग किए जा सकते हैं।
यह वह जगह है जहां पूर्व-प्रशिक्षण अधिक स्केलेबल हो जाता है। मानव वीडियो व्यापक ऑब्जेक्ट हेरफेर पैटर्न सिखा सकता है। रोबोट वीडियो मशीन विशिष्ट आंदोलन के लिए सीखने को लंगर दे सकता है. सिमुलेशन वीडियो दृश्यों और इंटरैक्शन की विविधता का विस्तार कर सकता है । RynnVLA-Latent इन स्रोतों को गुप्त कार्रवाई लक्ष्यों में जोड़ती है, फिर एम्बेडमेंट-विशिष्ट पोस्ट-ट्रेनिंग के माध्यम से पूर्व प्रशिक्षित नीति को मूल रोबोट नियंत्रण में स्थानांतरित करती है।
अवतार-विशिष्ट पोस्ट-प्रशिक्षण व्यावहारिक हैंडऑफ है। वीडियो पर प्रशिक्षित एक नीति अनुकूलन के बिना स्वचालित रूप से रोबोट के जोड़ों, ग्रिपर्स, पहियों या एक्ट्यूएटर्स को ड्राइव नहीं कर सकती है। पूर्व-प्रशासित गुप्त कार्रवाई प्रतिनिधित्व एक साझा प्रारंभिक बिंदु प्रदान करता है, जबकि पोस्ट-ट्रेनिंग उस प्रतिनिधित्व को सेंसर, कमांड प्रारूप और किसी विशेष रोबोट की मैकेनिकल बाधाओं के साथ संरेखित करता है।
प्रमाणीकरण जांच प्रतिनिधित्व और नीति
योगदान को दो स्तरों पर परीक्षण किया जाता हैः प्रतिनिधित्व गुणवत्ता और नीति प्रदर्शन। नियंत्रण की भविष्यवाणी की जांच के लिए जमे हुए-प्रतिनिधित्व जांच का उपयोग किया जाता है। इस सेटअप में, सीखा गया प्रतिनिधित्व तय रखा जाता है जबकि एक छोटी जांच यह देखने के लिए प्रशिक्षित की जाती है कि क्या प्रतिनिधित्व पहले से ही उपयोगी नियंत्रण संबंधी जानकारी शामिल करता है। इससे बाद में होने वाले ट्यूनिंग से प्रतिनिधित्व के मूल्य को अलग करने में मदद मिलती है।
इस पद्धति का मूल्यांकन सिमुलेशन और वास्तविक दुनिया के प्लेटफार्मों में हेरफेर प्रदर्शन के माध्यम से भी किया जाता है। रिपोर्ट किए गए परिणाम प्रतिस्पर्धी छेड़छाड़ प्रदर्शन हैं, जो सुझाव देते हैं कि गुप्त-कार्रवाई पथ न केवल एक आंतरिक प्रतिनिधित्व के रूप में बल्कि नियंत्रण के लिए व्यावहारिक प्रशिक्षण पुल के तौर पर उपयोगी है।
एक अन्य महत्वपूर्ण संकेत स्केलिंग व्यवहार है। योगदान में सुधार की ओर इशारा करता है क्योंकि गुप्त कार्रवाई पूर्व-प्रशिक्षण डेटा बढ़ता है। यह प्रवृत्ति मायने रखती है क्योंकि यह सुझाव देती है कि दृष्टिकोण केवल सावधानीपूर्वक मेल खाने वाले रोबोट-एक्शन लेबल पर भरोसा करने के बजाय अधिक वीडियो विविधता से लाभान्वित होता है।
पाठकों को आगे क्या देखना चाहिए
व्यावहारिक टेकअवे यह है कि वीडियो-आधारित रोबोट प्रशिक्षण एक पुनः प्रयोज्य प्रीट्रेनिंग पाइपलाइन के करीब हो रहा है। यदि कोई रोबोट 30.1K घंटे के मानव, रोबोट और सिमुलेशन वीडियो से साझा संक्रमण पैटर्न सीख सकता है, तो टीमों को एक मॉडल को नई मशीन में अनुकूलित करने से पहले कम हाथ से लेबल किए गए रोबोट एक्शन डेटा की आवश्यकता हो सकती है।
रोबोट सिस्टम बनाने या मूल्यांकन करने वाले पाठकों के लिए, अगला सवाल यह है कि नुस्खा कितनी दूर तक यात्रा करता है। विभिन्न कैमरा सेटअपों, अलग-अलग रोबोट बॉडीज और विभिन्न हेरफेर कार्यों में लैंटेंट-एक्शन प्रतिनिधित्व कितना अच्छा रहता है? अभी भी कितने अवतार-विशिष्ट पोस्ट-प्रशिक्षण की आवश्यकता है? सिमुलेशन और वास्तविक दुनिया प्लेटफार्मों पर रिपोर्ट किए गए सत्यापन से दृष्टिकोण का पालन करना उचित हो जाता है, लेकिन परिणाम एक तैयार उत्पाद के बजाय अनुसंधान योगदान बना हुआ है।
Comments (0)