
एक व्यापक गाइड बताता है कि 3 डी जनरेशन मॉडल को कैसे ठीक किया जाए।
Hugging Face स्क्रिप्ट और Docker छवियां उपयोगकर्ताओं को कस्टम 3 डी परिसंपत्तियों पर TRELLIS.2 को ठीक करने की अनुमति देती हैं, निम्न-रैंक अनुकूलन के माध्यम से ऑब्जेक्ट ज्यामिति में सुधार करती हैं।
मुख्य जानकारी
- Hugging Face ने स्थानीय Docker या Hugging Face Jobs का उपयोग करके कस्टम 3 डी परिसंपत्तियों पर TRELLIS.2, एक लोकप्रिय 3D पीढ़ी मॉडल को ठीक करने के लिए स्क्रिप्ट और कंटेनर छवियां जारी कीं।
- मार्गदर्शिका 3 डी पीढ़ी में एक आम समस्या को संबोधित करती हैः पूर्व प्रशिक्षित मॉडल दृश्य रूप से प्रशंसनीय वस्तुओं का उत्पादन कर सकते हैं लेकिन सटीक श्रेणी-विशिष्ट ज्यामिति पर विफल हो जाते हैं, जैसे कि जूते के तलवों या फर्नीचर आकार।
- अनुशंसित दृष्टिकोण कम रैंक अनुकूलन ( LoRA ) का उपयोग करता है TRELLIS.2 पाइपलाइन के केवल चयनित चरणों को प्रशिक्षित करने के लिए, विशेष रूप से मोटी संरचना और विस्तृत ज्यामिति, जबकि सामग्री उत्पादन फ्रीज रखते हुए।
- LoRA छोटे datasets के लिए अच्छी तरह से अनुकूल है क्योंकि इसे पूर्ण fine-tuning की तुलना में बहुत कम प्रशिक्षित मापदंडों और कम मेमोरी की आवश्यकता होती है, जबकि आधार मॉडल की मौजूदा ताकत को संरक्षित किया जाता है।
- लेख में 188 फुटवियर वस्तुओं के साथ कार्यप्रवाह का प्रदर्शन किया गया है, जिसमें दिखाया गया है कि कैसे लक्षित fine-tuning पूर्ण 3 डी पीढ़ी मॉडल को फिर से बनाने के बिना श्रेणी-विशिष्ट आकार सटीकता में सुधार कर सकता है।
A Hugging Face blog ने fine-tuning TRELLIS.2 के लिए स्क्रिप्ट और कंटेनर छवियों को प्रकाशित किया है, जो एक उपयोगकर्ता की अपनी 3 डी परिसंपत्तियों पर एक लोकप्रिय 3 डी जनरेशन मॉडल है। उपकरण या तो Docker के साथ स्थानीय मशीन पर चलाने के लिए डिज़ाइन किए गए हैं Hugging Face Jobs, कंटेनरीकृत वर्कलोड के लिए cloud service । लेख उन लोगों के लिए उपयोगी है जिन्हें पूरे मॉडल का पुनर्निर्माण किए बिना किसी ऑब्जेक्ट श्रेणी जैसे जूते या फर्नीचर के लिए बेहतर व्यवहार करने के लिए पूर्व-प्रशिक्षित 3D मॉडल की आवश्यकता होती है।
क्यों मानक 3 डी पीढ़ी को नियंत्रित करना मुश्किल है
3 डी पीढ़ी रोबोटिक्स, सिमुलेशन, मीडिया और मनोरंजन में मायने रखती है। इन क्षेत्रों को अक्सर सख्त नियमों का पालन करने और सुसंगत प्रतिनिधित्व का उपयोग करने के लिए उत्पन्न वस्तुओं की आवश्यकता होती है। ब्लॉग नोट करता है कि कई फ़ाइल प्रारूप मौजूद हैं, जिनमें जीएलबी और पीएलवाई शामिल हैं, और कई मॉडल प्रतिनिधित्व मौजूद हैं जिसमें तंत्रिका विकिरण क्षेत्र और 3 डी गॉसियन स्प्लैटिंग शामिल हैं। प्रत्येक व्यापार-बंद है।
ट्रेलिस ने एक एकीकृत अव्यक्त प्रतिनिधित्व पेश किया, एक संपीड़ित आंतरिक रूप जिसे विभिन्न 3 डी आउटपुट प्रारूपों में डिकोड किया जा सकता है। TRELLIS.2 ने मॉडल की 3 डी संरचना के प्रतिनिधित्व में सुधार किया। ब्लॉग के अनुसार, लापता टुकड़ा किसी भी मॉडल को विशिष्ट कार्य के लिए अनुकूलित करने का एक सरल तरीका है।
जूते का एक प्रयोग समस्या को दर्शाता है
उदाहरण संकीर्ण हैः टीम ने 188 फुटवियर वस्तुओं वाले dataset के एक उपसमूह का उपयोग किया। प्रारंभिक परीक्षणों में, पूर्व-प्रशिक्षित TRELLIS.2 मॉडल ने ऐसे जूते बनाए जो आम तौर पर सही लग रहे थे, लेकिन तलवे अक्सर गलत होते थे। टीम यह जांचना चाहती थी कि क्या कम रैंक अनुकूलन, मूल भार को जमे हुए रखते हुए छोटे एडाप्टर मैट्रिक्स को प्रशिक्षित करने वाली एक विधि, एकमात्र ज्यामिति में सुधार कर सकती है।
यह उदाहरण महत्वपूर्ण है क्योंकि एक सामान्य प्रयोजन 3 डी मॉडल दृश्य व्यावहारिकता के लिए पर्याप्त अच्छा हो सकता है लेकिन ऐसी श्रेणी के लिए नहीं जहां सटीक आकार महत्वपूर्ण है। ब्लॉग का कहना है कि उपयोगकर्ताओं को फर्नीचर मॉडलों के लिए सटीक ज्यामिति की आवश्यकता हो सकती है, और पूर्व-प्रशिक्षित मॉडल उस कार्य के लिए अपर्याप्त रूप से सटीक ज्यामितीय उत्पादन कर सकते हैं।
पाइपलाइन संरचना, विस्तृत ज्यामिति और सामग्रियों को अलग करती है। टीम की योजना केवल कार्य के लिए महत्वपूर्ण घटकों को ठीक करने और दूसरों को फ्रीज करने की है। यह चुनना कि क्या फ्रीज करना है JUST के रूप में वर्णित किया गया है जितना कि प्रशिक्षण लेने का चयन करना उतना ही महत्वपूर्ण है।
TRELLIS.2 के कौन से चरणों को बदल दिया जाता है
TRELLIS.2 में पांच मुख्य चरण हैंः छवि पृष्ठभूमि को हटा दें, छवि को एन्कोड करें, मोटी संरचना की भविष्यवाणी करें, विस्तृत ज्यामिति उत्पन्न करें और सामग्री उत्पन्न करें। पाइपलाइन परिणाम को एक बनावट वाली जाली के रूप में निर्यात करती है।
BiRefNet इनपुट इमेज से पृष्ठभूमि को हटा देता है. DINOv3-L तब छवि को फीचर tokens में एन्कोड करता है जो 3 डी ऑब्जेक्ट का मार्गदर्शन करते हैं।
पहला प्रशिक्षित चरण छिटपुट-संरचना प्रवाह प्रसार Transformer है, जो फैलाव आधारित पीढ़ी में उपयोग किया जाने वाला एक मॉडल है। यह 163 × 8 के आकार के लैंटेन्ट के रूप में ऑब्जेक्ट की मोटी आकृति का अनुमान लगाता है। एक परिवर्तनशील ऑटोकोडर डिकोडर, एक प्रकार का एन्कोडर-डिकोडर मॉडल, उस लुप्त को 64 × 64 × 64-ऑक्यूपेंसी ग्रिड में बदल देता है। ग्रिड़ में प्रत्येक वॉक्सल चिह्नित करता है कि क्या वह स्थान वस्तु का हिस्सा है; एक वोक्सल तीन आयामों में एक पिक्सेल है। ब्लॉग यहां कम रैंक वाले एडाप्टर जोड़ता है क्योंकि यह आउटपुट बाद के ज्यामिति चरण का मार्गदर्शन करता है।
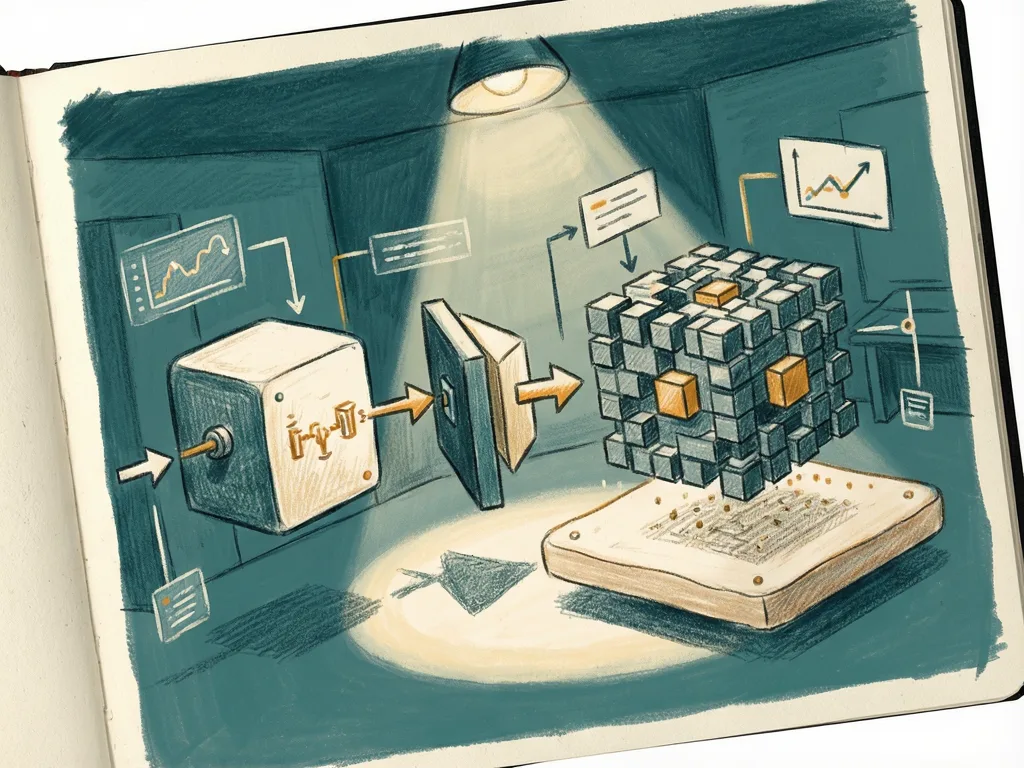
TRELLIS.2 3D वस्तुओं को O-Voxel में संग्रहीत करता है, एक विरल वोक्सल ग्रिड जो ऑब्जेक्ट की सतह पर केवल voxels रखता है। प्रत्येक वॉक्सेल स्थानीय ज्यामिति जैसे कि मेष वर्टेक्स और सामग्री विशेषताओं को स्टोर करता है। स्रोत का कहना है कि CPU सेकंड के भीतर ओ-वोक्सल में जाली बदल सकता है, और GPU सेकंड में ओ-वॉक्सल को वापस जाल में परिवर्तित कर सकता है।
ट्रेलिस के संरचित विरल लैंटेंट्स 3 डी डेटा को विरल टेंसर में रखते हैं, जो गणना को तेज करता है। ब्लॉग का कहना है कि मॉडल ग्रिड में केवल लगभग 10% वॉक्सल का उपयोग करता है, इसलिए यह खाली वोकल्स पर कंप्यूटिंग खर्च नहीं करता है. आकार प्रवाह और बनावट प्रवाह प्रसार Transformers बिखरे हुए हैं Transformers , जबकि बिखरा हुआ-संरचना प्रवाह फैलाव Transformer घना है।
ज्यामिति चरण आकार प्रवाह प्रसार Transformer का उपयोग करता है। यह एक गुप्त बनाने के लिए अधिभोग ग्रिड और DINOv3-L सुविधा tokens लेता है, जिसे भिन्नता ऑटोकोडर डिकोडर 512 × 512 x 512 रिज़ॉल्यूशन पर O-Voxel ज्योमेट्री में परिवर्तित कर देता है। टीम इस चरण में निम्न रैंक एडेप्टर जोड़ती है क्योंकि यह ऑब्जेक्ट की आकृति को नियंत्रित करती है।
सामग्री चरण जमे हुए है। बनावट प्रवाह फैलाव Transformer सतह की सामग्रियों और बनावट को परिभाषित करने के लिए आकार गुप्त और DINOv3-L सुविधाओं का उपयोग करता है। एक भिन्नता ऑटोकोडर डिकोडर लैंटेंट को प्रत्येक वोक्सल के लिए आधार रंग, धातु, खुरदरापन और अल्फा मानों में बदल देता है। ब्लॉग कहता है कि dataset में फैलाने वाले रंग नक्शे हैं लेकिन इस स्तर को प्रशिक्षित करने में आवश्यक अलग-अलग सामग्री नक्शे नहीं हैं। यह भी नोट करता है कि समस्या जूते, आकार है और मूल मॉडल पहले से ही अच्छे रंग और बनावटी बनाता है।
अंत में, पाइपलाइन ज्यामिति और सामग्री विशेषताओं को एक बनावट वाले मेष में जोड़ती है और इसे GLB फ़ाइल के रूप में निर्यात करती है।
क्यों कम रैंक अनुकूलन एक छोटे dataset फिट बैठता है
Google Scanned Objects सबसेट में 1,030 ऑब्जेक्ट्स से 188 जूते हैं। इस छोटे dataset के लिए, ब्लॉग का कहना है कि पूर्ण fine-tuning की लागत बहुत अधिक है और जो मॉडल पहले से ही अच्छी तरह से करता है उसे ओवरराइट कर सकता है। लो-रैंक अनुकूलन प्रशिक्षित मापदंडों की संख्या को कम करता है और उनके ग्रेडिएंट और ऑप्टिमाइज़र राज्य के लिए आवश्यक मेमोरी।
स्रोत एडेप्टरों को जोड़ने और प्रशिक्षित करने के लिए एक Hugging Face पैरामीटर-कुशल fine-tuning लाइब्रेरी का उपयोग करता है। Hugging Face Jobs में कस्टम फॉरवर्ड पास होता है, मानक रैपर पर भरोसा करने के बजाय एडाप्टर सीधे मॉडल में डाले जाते हैं।
कॉन्फ़िगरेशन दो लक्षित प्रसार Transformers के लिए कुल मिलाकर लगभग 9.3 मिलियन एडाप्टर मापदंडों को प्रशिक्षित करता है। यह विरल-संरचना प्रवाह फैलाव Transformer की ध्यान और फीड-फॉरवर्ड परतों में रैंक 8 एडेप्टर का उपयोग करता है, और आकार फ्लो फैलावा Transformer . के ध्यान स्तरों में 16 एडप्टर रैंक देता है। रैंक एडेप्टर मैट्रिक्स के आकार सेट करता है; एक उच्च रैंक से एडेपटर अधिक सीख सकता है।
ट्रेनिंग सेटअप डेटा एक्सपोजर को भी सीमित करता है। 188 ऑब्जेक्ट्स में से, 9 मूल्यांकन के लिए रखे जाते हैं और 179 का उपयोग प्रशिक्षण के लिए किया जाता है। ब्लेंडर प्रत्येक वस्तु के 16 दृश्यों को प्रस्तुत करता है, और प्रत्येक प्रशिक्षण नमूना कंडीशनिंग छवि के रूप में एक यादृच्छिक दृश्य का उपयोग करता है. 4 ग्रेडिएंट संचय चरणों के साथ 4 का बैच आकार प्रभावी बैच का आकार देता है 16.
स्रोत संख्यात्मक स्थिरता के लिए 32-बिट फ्लोटिंग पॉइंट में ट्रेनेबल एडाप्टर वेट्स रखता है और फॉरवर्ड पास के लिए bfloat16 ऑटोकास्टिंग का उपयोग करता है। ऑटोकैस्टिंग PyTorch को कुछ ऑपरेशनों के लिए कम परिशुद्धता का उपयोग करने देता है, जो मेमोरी उपयोग को कम करता है और यह नहीं बदलता कि जमे हुए रीढ़ की हड्डी वजन कैसे संग्रहीत किए जाते हैं।
पाइपलाइन कैसे चलाएं
ब्लॉग दो Docker छवियों की आपूर्ति करता हैः एक पूर्व-प्रसंस्करण के लिए और दूसरा fine-tuning के लिए। उन्हें Hugging Face Jobs या स्थानीय रूप से चलाया जा सकता है। शुरू करने से पहले, उपयोगकर्ताओं को Hugging Face एक्सेस token , Hugging Face खाते की आवश्यकता होती है जो DINOv3 तक पहुंच सकते हैं क्योंकि यह एक गेट मॉडल है, और Hugging Face Hub पर अपलोड किए गए मेष यदि वे अपने स्वयं के dataset का उपयोग करते हैं।
प्रीप्रोसेसिंग चरण GLB या OBJ मेषों को लैंटेंट प्रतिनिधित्व में परिवर्तित करता है TRELLIS.2 प्रशिक्षण के लिए उपयोग करता है और इनपुट छवियों को प्रस्तुत करता है। ट्रेलिस 2 के जमे हुए एन्कोडर इनपुट मेशों को ट्रेनिंग लैटेन्ट में बदल देते हैं, और ब्लॉग का कहना है कि ये लेटेन्ट्स सहेजे जाते हैं ताकि बाद के रन को फिर से मैशे को एनकोड न करना पड़े। पूर्व-संसाधित dataset भी बचाया जाता है इसलिए प्रशिक्षण रन इसे पुनः उपयोग कर सकते हैं।
Hugging Face Jobs के लिए, प्रीप्रोसेसिंग कंटेनर पाइपलाइन के माध्यम से विचारों और प्रक्रियाओं को प्रस्तुत करता है। 188 फुटवियर ऑब्जेक्ट्स के लिए A100 -लार्ज जॉब पर पूर्ण पूर्व प्रसंस्करण रन में लगभग 1 घंटे का समय लगा। एक साथी रिपॉजिटरी में प्री प्रोसेसिंग पाइप लाइन का एक कॉम्पैक्ट संस्करण भी उपलब्ध है।
प्रशिक्षण कंटेनर तैयार dataset और एक कॉन्फ़िगरेशन प्रीसेट या फ़ाइल लोड करता है, और ट्रेकियो के साथ प्रशिक्षण मैट्रिक्स रिकॉर्ड करता है। यह दो मोड का समर्थन करता हैः एक विरल-संरचना प्रवाह प्रसार Transformer के लिए और दूसरा आकार फ्लो फैलाव Transformer . हुड के नीचे, ये मोड प्रत्येक चरण के लिए अलग-अलग विन्यास फाइलों को संदर्भित करते हैं। यदि --push-to विकल्प सेट किया गया है, तो कन्टेनर एडाप्टर चेकपॉइंट्स को अपलोड करता है Hugging Face Hub.
Docker के साथ स्थानीय रूप से एक ही आदेश और झंडे का उपयोग किया जाता है, सिवाय Docker -विशिष्ट विकल्पों के लिए। प्रशिक्षित कम रैंक एडाप्टर रिपॉजिटरी suvadityamuk/trellis-2-finetune-gso में उपलब्ध हैं।
पाठकों को आगे क्या देखना चाहिए
ब्लॉग एक व्यावहारिक मार्ग प्रदान करता है: मेषों को प्रशिक्षण अव्यक्त में परिवर्तित करें, दृश्य प्रस्तुत करें, आकार-संबंधी चरणों के लिए ट्रेन एडेप्टर और सहेजे गए dataset का पुनः उपयोग करें। सबसे उपयोगी टेकवे क्या बदलता है और क्या तय रहता है के बीच विभाजन है। आकृति समस्याओं के लिए, लेख स्पार्स स्ट्रक्चर फ्लो और शेप फ्लो स्टेप्स की ओर इशारा करता है। सामग्री की समस्याओं के लिये यह चेतावनी देता है कि मिश्रित फैला हुआ रंग मानचित्र मॉडल को सतह के रंग के रूप में प्रकाश सीखने का कारण बन सकता है और विनाशकारी भूलने का जोखिम उठा सकता है।
यह अंतर उपयोगकर्ताओं को निर्णय लेने में मदद कर सकता है कि क्या 3 डी मॉडल को ठीक से ट्यून करना है, और प्रशिक्षण प्रयास कहां रखा जाए। जूते का परीक्षण मामला परिणामों की जांच करने के लिए एक ठोस तरीका भी प्रदान करता हैः 9 आयोजित वस्तुओं के खिलाफ उत्पन्न ऑब्जेक्ट्स की तुलना करें, और उस विवरण पर करीब से नज़र डालें जो कार्य के लिए सबसे अधिक मायने रखता है, जैसे जूता तलवों।
Comments (0)